 Actualizado: 26 de octubre de 2026
 24 minutos de lectura
Pasar los datos de una página web a una hoja de cálculo parece una tarea sencilla. Entonces descubre que el precio está en una segunda página, que el plan gratuito no permite ejecutar la tarea mientras su portátil está apagado y que «10 000 créditos» no significa 10 000 registros utilizables. Elegiría una herramienta de scraping en función de esos detalles antes de comparar cuántas funciones ofrece.
Mis opciones de un vistazo
Para tablas con actualizaciones periódicas sin código, elegiría Browse AI; para desarrolladores que quieran obtener HTML mediante una API, ScrapingBee. Apify es adecuado para tareas prediseñadas en la nube; Firecrawl, para contenido destinado a aplicaciones de AI; Octoparse ofrece flujos de trabajo visuales de escritorio con una opción de pago en la nube; y Scrapy permite a los desarrolladores de Python controlar el rastreo y los resultados.
Cómo comprobé estas herramientas y declaración de transparencia editorial
Probé el «HTML Playground» de ScrapingBee y la vista previa pública de Firecrawl, abrí el flujo de trabajo gratuito con AI de Octoparse, procesé un catálogo sintético con Scrapy y comparé guías oficiales, precios y debates públicos entre usuarios. Estas pequeñas comprobaciones abarcan la configuración y los resultados, no la fiabilidad en producción. Linked Helper publica este blog y ofrece una herramienta independiente de automatización de LinkedIn; no es una de las opciones seleccionadas.
¿Qué es una herramienta de web scraping?
Una herramienta de web scraping recupera páginas web y extrae contenido en un formato utilizable, como HTML, Markdown, CSV o JSON. Algunas herramientas permiten seleccionar campos visualmente; otras proporcionan a los desarrolladores una API o un marco de desarrollo. El rastreo descubre páginas, mientras que la extracción convierte su contenido en los registros que necesita.
Las mejores herramientas de web scraping de un vistazo
| Herramienta | Ideal para | Función destacada | Precio inicial | Principal inconveniente |
|---|---|---|---|---|
| Browse AI | Tablas con actualizaciones periódicas sin código | Robots visuales y supervisión | 19 USD/mes, facturados anualmente; plan gratuito disponible | Las filas y las ejecuciones consumen créditos |
| Apify | Tareas prediseñadas en la nube | Mercado de Actors y conjuntos de datos | 19 USD/mes, facturados mensualmente; plan gratuito disponible | Los cargos de los Actors varían |
| ScrapingBee | HTML mediante una API | Opciones de renderizado y proxy | 19 USD/mes, facturados mensualmente | Su equipo crea el flujo de trabajo de datos |
| Firecrawl | Contenido para aplicaciones de AI | Markdown y formatos estructurados | 19 USD/mes, facturados mensualmente; plan gratuito disponible | JSON consume créditos adicionales |
| Octoparse | Flujos de trabajo visuales del escritorio a la nube | Extracción local y programación en la nube con un plan de pago | 69 USD/mes, facturados anualmente; plan gratuito disponible | La programación clásica en la nube requiere un plan de pago |
| Scrapy | Rastreos personalizados con Python | Selectores, pipelines y exportaciones de datos | 0 USD por la licencia del software | Su equipo mantiene el sistema |
¿Qué distingue a las mejores herramientas de web scraping?
Una buena herramienta de scraping entrega los campos que necesita, en un formato que pueda usar en la siguiente etapa y con un coste previsible. Empezaría con una página representativa que incluya la parte complicada del trabajo: la paginación, los precios que faltan o un campo que solo aparece después de hacer clic.
El resultado que realmente necesita. HTML resulta útil cuando está escribiendo un analizador. Markdown resulta útil cuando una aplicación de AI necesita contenido legible de una página. Una hoja de cálculo necesita columnas estables. No pague por una conversión de formato que vaya a deshacer de inmediato.
Dónde se encuentran los datos. Veinte productos en una página de listado y veinte páginas de productos individuales generan cargas de trabajo distintas. Compruebe si la herramienta debe abrir cada página de detalles, renderizar JavaScript o seguir otro conjunto de enlaces.
Quién la mantiene en funcionamiento. Una herramienta de escritorio gratuita puede bastar para una exportación mensual supervisada. Una tarea diaria necesita un entorno donde ejecutarse, una programación y un sistema para detectar resultados que faltan. El alojamiento en la nube elimina parte del trabajo, pero no la necesidad de comprobar los datos.
Un desglose de costes que pueda verificar. Busque el cargo por solicitud, fila, evento o unidad de computación. Después, compruebe los extras asociados a la configuración que utilizará. Una solicitud básica barata puede convertirse en una operación más cara que requiera un navegador o funciones de AI.
Una muestra pequeña y fácil de revisar. Conviene comparar algunos de los campos devueltos con la fuente antes de programar nada. Un código de estado HTTP satisfactorio indica que una solicitud se completó; no indica que se hayan recibido todos los productos esperados.
Las seis opciones abarcan herramientas visuales, API gestionadas en la nube y código personalizado. Los contratos empresariales de entrega de datos y las herramientas especializadas en plataformas sociales responden a necesidades de compra más específicas, por lo que aquí no los he tratado como opciones intercambiables.
1. Browse AI: la mejor para tablas con actualizaciones periódicas sin código
Ventajas — Browse AI
-
Los robots visuales permiten supervisar páginas y repetir las extracciones de forma periódica.
-
«Table Studio» propone campos a partir de una URL sin requerir una extensión del navegador.
Desventajas — Browse AI
-
Las ejecuciones independientes de páginas de detalles pueden consumir muchos más créditos que una extracción de una única página de listado.
-
El límite de 50 créditos del plan Free es escaso para la supervisión diaria.
Browse AI es mi elección cuando el objetivo final es una tabla actualizada y no quiere mantener selectores en el código. «Table Studio» parte de la URL de una página y propone columnas y filas de muestra. Revise los campos, elija cuántos elementos quiere capturar y guarde el robot para repetir las ejecuciones.
Me gusta esa separación entre configurar la tabla y programar sus actualizaciones. Si supervisa el catálogo de un proveedor, puede pensar en las columnas que necesita en lugar de la solicitud que recupera cada página. Sin embargo, «Table Studio» sigue en fase beta y los recorridos interactivos deben configurarse en «Robot Studio»: interactuar con un formulario mediante varios clics es una tarea distinta de leer una lista que ya está visible.
Observaciones — Browse AI
Contaría las visitas a páginas antes que las filas. Según las reglas de créditos estándar, 20 elementos de una sola página de listado cuestan dos créditos. Ejecutar un robot por separado en 20 páginas de detalles cuesta al menos 20 créditos, sin contar las ejecuciones utilizadas para descubrir esos enlaces. El coste es diez veces mayor para el mismo número de elementos.
El problema es la rapidez con la que las ejecuciones repetidas consumen el límite gratuito. La extracción diaria de una lista de 20 filas utiliza 60 créditos en un mes de 30 días, justo por encima de los 50 del plan Free. Descartaría esta opción si su equipo ya quiere escribir su propio analizador y controlar cada solicitud; estaría pagando por un flujo de trabajo visual que quizá no necesite.
Precios de Browse AI
Desde 19 USD/mes, facturados anualmente, para Personal; plan Free disponible.
-
Free — 50 créditos/mes en dos sitios web.
-
Personal — 19 USD/mes, facturados anualmente, con 12 000 créditos proporcionados por adelantado cada año.
-
Professional — 69 USD/mes, facturados anualmente, con 60 000 créditos anuales y diez sitios web.
2. Apify: la mejor para tareas prediseñadas de scraping en la nube
Ventajas — Apify
-
Los Actors específicos para determinados sitios web pueden evitar que tenga que crear un extractor desde cero.
-
Los conjuntos de datos admiten formatos como CSV, JSON y Excel.
Desventajas — Apify
-
Cada Actor tiene sus propios requisitos de entrada y modelo de cobro.
-
El crédito de la plataforma no equivale a un número fijo de filas.
Vale la pena considerar Apify cuando ya existe un Actor prediseñado que cubre el sitio o flujo de trabajo que le interesa. Un Actor es un programa que puede ejecutar en la nube de Apify; puede ser una herramienta de scraping especializada o una herramienta más general que requiera configuración adicional. La pregunta útil es si ese Actor concreto devuelve los campos que necesita.
Me gusta tener la ejecución y el acceso al conjunto de datos en la misma plataforma. Puede empezar con un Actor adecuado, revisar su resultado de muestra y configurar otra aplicación para que utilice el conjunto de datos. Es un punto de partida más útil que comprar infraestructura antes de encontrar un extractor que funcione.
Aun así, hay que elegir el Actor con cuidado. En un debate de r/scrapingtheweb (septiembre de 2026), u/Heiswasistocome escribió: “I am looking at Apify and feeling overwhelmed at the number of actors who can do what I want them to do.” Acotaría la búsqueda según los campos de salida, el mantenimiento reciente y una pequeña ejecución de muestra, en lugar de basarme únicamente en la popularidad.
El problema es que hay dos niveles de cobro. Los Actors pueden cobrar por eventos o por uso, con los costes de la plataforma incluidos o separados según el Actor. La unidad de computación de Apify mide el uso de un gigabyte de RAM durante una hora; no indica cuántos productos obtendrá. Descartaría Apify si busca un precio uniforme por página para distintas herramientas de scraping.
Conviene comprobar un detalle de la exportación antes de diseñar una hoja de cálculo para las fases posteriores: al seleccionar campos de un conjunto de datos, solo se admiten nombres del nivel superior, mientras que la opción para omitir campos admite rutas anidadas. Es posible que tenga que reestructurar un resultado anidado antes de convertirlo en la tabla plana que imaginaba.
Precios de Apify
Desde 19 USD/mes, facturados mensualmente, para Starter, más los cargos por el uso que exceda el crédito incluido; plan Free disponible.
-
Free — 5 USD de uso de la plataforma cada mes.
-
Starter — el importe de la suscripción se incluye como crédito de uso.
-
Cargos de los Actors — compruebe por separado los eventos, el uso y los costes de plataforma incluidos del Actor seleccionado.
3. ScrapingBee: la mejor para obtener HTML mediante una API
Ventajas — ScrapingBee
-
Las solicitudes de HTML sin procesar pueden costar un crédito cada una.
-
Las opciones de renderizado, proxy y extracción se ofrecen mediante una única API.
Desventajas — ScrapingBee
-
La configuración modifica el coste en créditos de cada solicitud.
-
La programación, el almacenamiento y la validación posterior siguen siendo responsabilidad de su equipo.
ScrapingBee es mi elección para desarrolladores que quieren delegar la recuperación de páginas sin adquirir una plataforma visual completa de datos. Envíe una URL y una configuración y trabaje después con la respuesta en su propia aplicación. Esto encaja en un proceso existente en el que ya sabe cómo analizar, almacenar y comprobar los resultados.
Probé su «HTML Playground» con una página del entorno de pruebas Books to Scrape. Con «Auto mode» desactivado y el renderizado de JavaScript inhabilitado, la solicitud devolvió HTTP 200 y la interfaz mostró que se había descontado un crédito. Fue una comprobación útil de la configuración; una página de demostración sencilla dice poco sobre los sitios difíciles.
Observaciones — ScrapingBee
Conviene revisar los controles antes de ejecutar la solicitud. El «Playground» se inició con «Auto mode» habilitado. Cuando lo desactivé, el renderizado de JavaScript aparecía marcado por separado; al desactivarlo, obtuve la configuración deseada, con un coste de un crédito. La configuración predeterminada de renderizado de JavaScript de la API cuesta cinco créditos, mientras que una solicitud básica sin esta opción cuesta uno.
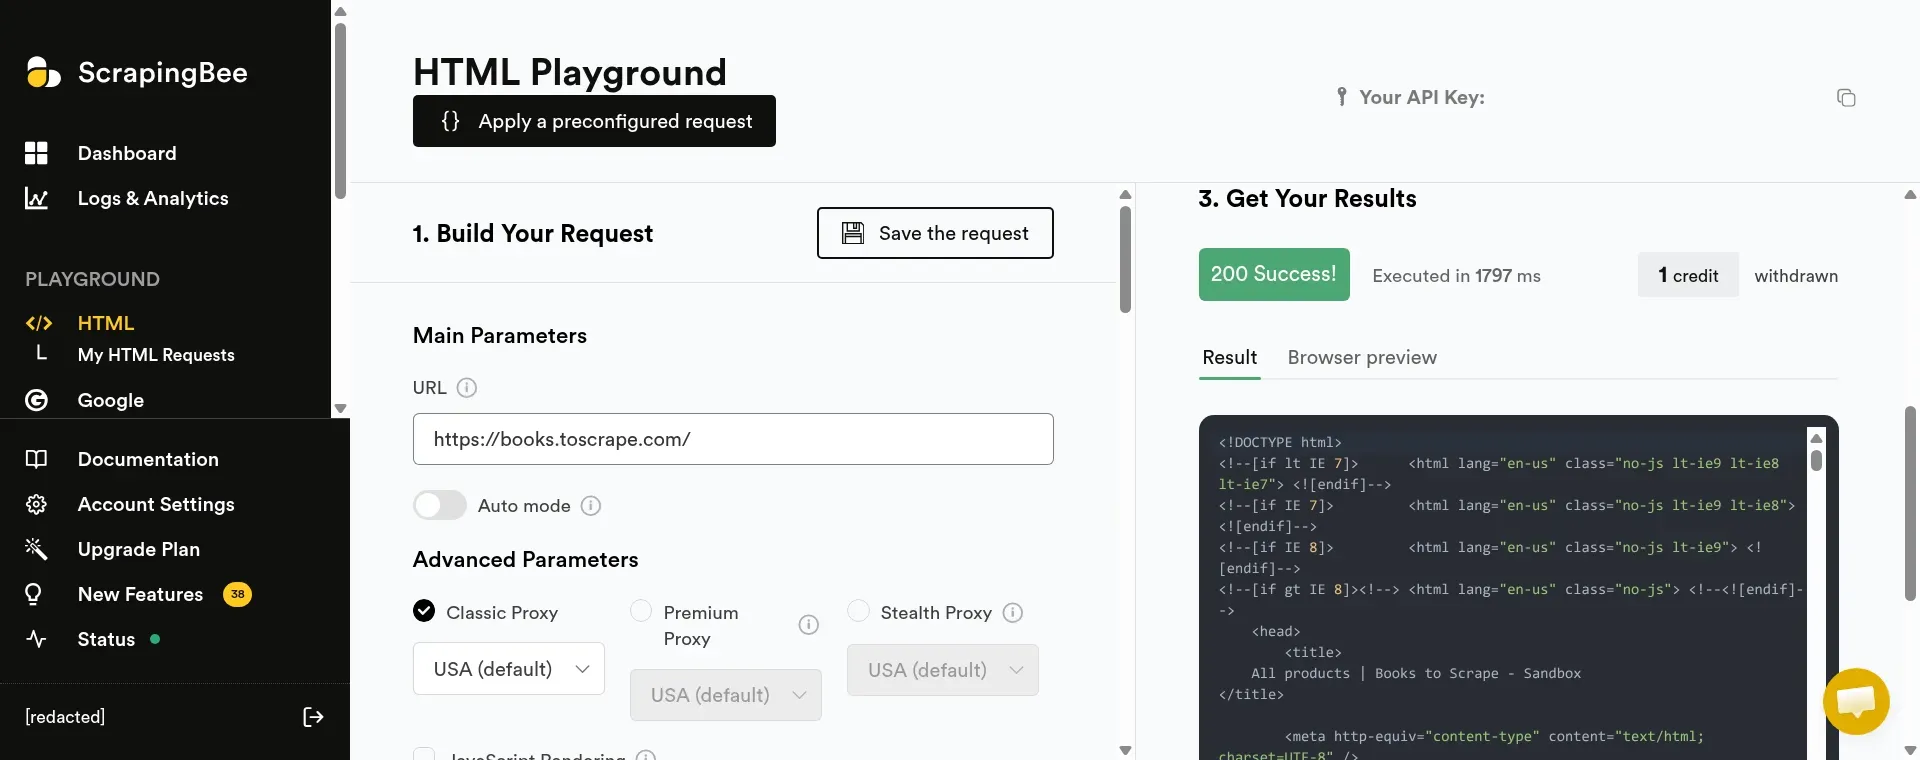
En el «HTML Playground» de ScrapingBee, la solicitud de una página básica devolvió un resultado y mostró que se había descontado un crédito.
Me gusta este control cuando sus páginas no necesitan un navegador, porque puede evitar pagar por un renderizado innecesario. El problema es que todavía tendrá que convertir la página recuperada en registros fiables. Descartaría esta opción si quiere una hoja de cálculo de supervisión terminada sin tener que crear un flujo de trabajo en torno a la API.
Precios de ScrapingBee
Desde 19 USD/mes, facturados mensualmente, para Hobby; hay disponible una prueba de 1000 créditos.
-
Hobby — 19 USD/mes por 75 000 créditos y 25 solicitudes simultáneas.
-
Freelance — 49 USD/mes por 250 000 créditos y 50 solicitudes simultáneas.
-
Configuración de las solicitudes — el HTML estándar cuesta un crédito; el renderizado de JavaScript cuesta cinco; las opciones prémium cuestan más.
4. Firecrawl: la mejor para contenido destinado a aplicaciones de AI
Ventajas — Firecrawl
-
Devuelve contenido en Markdown y HTML, además de datos estructurados.
-
Un «Playground» público permite probar una página y revisar una vista previa.
Desventajas — Firecrawl
-
La extracción de JSON estructurado añade créditos al coste básico de la página.
-
Una vista previa generada correctamente no sustituye la comprobación del resultado completo.
Firecrawl es mi elección cuando el siguiente paso necesita contenido legible de la página en lugar de HTML sin procesar. Markdown tiene sentido para los flujos de recuperación de información y los flujos de trabajo con AI; JSON estructurado tiene sentido cuando un proceso posterior espera campos definidos, como producto, precio y moneda. Me gusta disponer de esas opciones en un mismo lugar, pero decidiría qué resultado necesito antes de calcular el coste.
Envié la página del entorno de pruebas Books to Scrape al «Playground» público y obtuve una vista previa en Markdown. Conservó el enlace «Home» y el encabezado «All products». El resultado completo requería una cuenta, así que mi comprobación terminó en esa vista previa en lugar de incluir una exportación verificada de todos los productos.
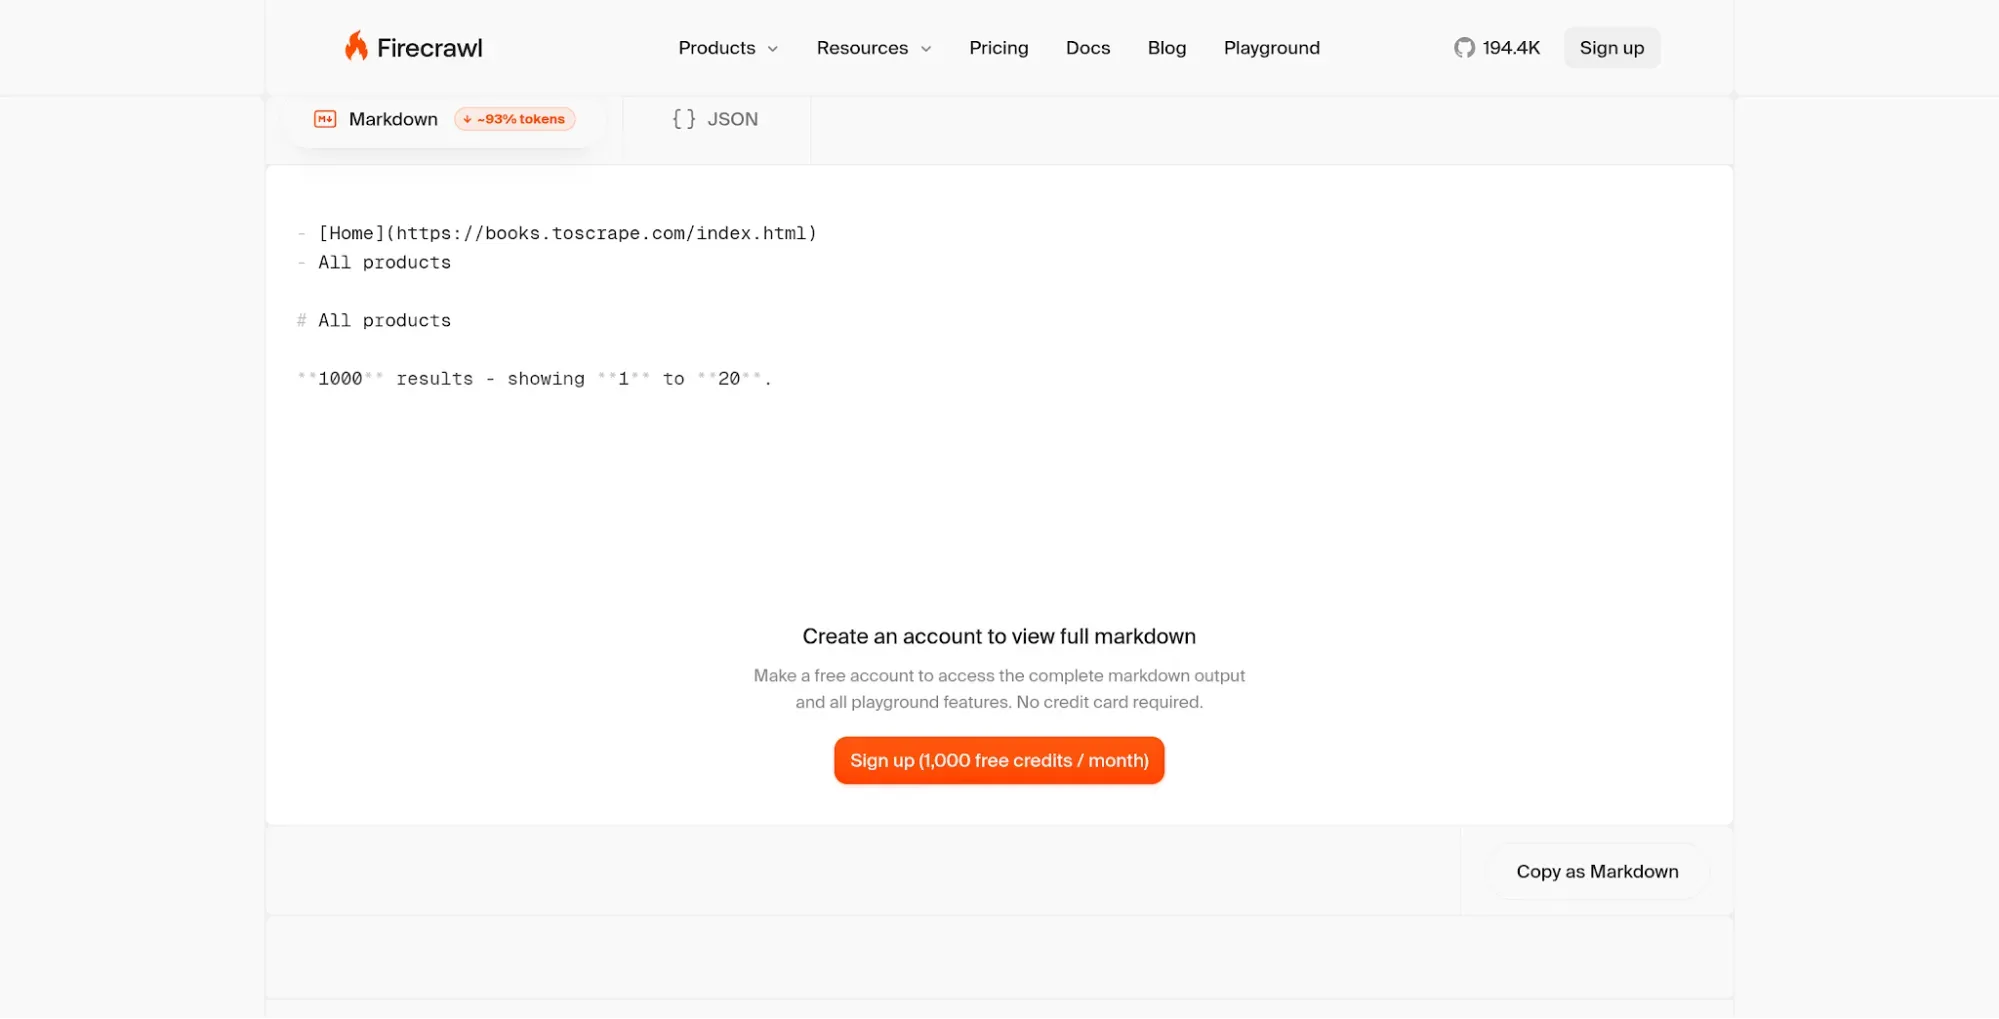
En el «Playground» público de Firecrawl, la vista previa en Markdown conserva la navegación y el encabezado de la página; el resultado completo requiere una cuenta.
Ese pequeño detalle importa: el contenido legible en Markdown no se convierte automáticamente en una tabla con campos de producto limpios. Si va a cargar un catálogo en una base de datos, seguirá necesitando un esquema y comprobaciones de valores ausentes. Si va a proporcionar el contexto de una página a una aplicación de AI, una representación textual más amplia puede ser exactamente lo que necesita.
El inconveniente es que el coste se multiplica según el formato de salida. Una extracción básica cuesta un crédito por página; añadir la extracción de JSON eleva el coste a cinco. En una publicación de r/automation (septiembre de 2026), u/Rankspartanben elogió el servicio de asistencia de Firecrawl, pero lo calificó de “quite expensive”. Lo tomaría como una señal para calcular el coste del formato y el volumen que necesita, no como un motivo para descartar la herramienta.
Descartaría Firecrawl si solo necesita realizar ocasionalmente una extracción a CSV mediante una interfaz visual. Sus funciones de conversión y API tienen más sentido cuando está creando un flujo de procesamiento de contenido recurrente.
Precios de Firecrawl
Desde 19 USD/mes, facturados mensualmente, para Hobby; plan Free disponible.
-
Free — 1000 créditos renovados mensualmente.
-
Hobby — 19 USD/mes por 5000 créditos mensuales; los créditos adicionales cuestan 5 USD por cada 1000.
-
Standard — 99 USD/mes por 100 000 créditos mensuales.
5. Octoparse: la mejor para flujos de trabajo visuales que pasan del escritorio a la nube
Ventajas — Octoparse
-
La extracción local gratuita le permite empezar sin una suscripción.
-
Standard añade extracción en la nube, programación y una API de exportación de datos.
Desventajas — Octoparse
-
La programación clásica en la nube requiere un plan de pago; los límites de la beta de AI son diferentes.
-
Los servicios opcionales de proxy y configuración pueden aumentar el precio del plan.
Vale la pena considerar Octoparse cuando quiere crear de forma visual flujos de trabajo de extracción y conservar la opción de ejecutarlos en la nube. Puede empezar con plantillas, su «AI Assistant» o la aplicación de escritorio. Los planes de pago de la modalidad clásica añaden capacidad en la nube y programación para las tareas que no quiere mantener vinculadas a su propio ordenador.
Me gusta la distinción entre el trabajo local y en la nube porque le ofrece un criterio práctico para decidir si necesita un plan de pago. Si exporta un catálogo una vez al mes mientras trabaja en su ordenador, la opción local gratuita puede ser suficiente. Si ese mismo catálogo debe actualizarse cada mañana, la programación de Standard es la función que realmente está comprando.
En el flujo de trabajo clásico de la aplicación de escritorio, Free incluye diez tareas, un dispositivo y 50 000 filas de exportación al mes, con un máximo de 10 000 filas por exportación. Standard aumenta el cupo a 100 tareas e incluye hasta tres procesos simultáneos en la nube. Esas cifras miden cosas distintas: una tarea es un flujo de trabajo guardado, mientras que las filas exportadas son los datos que produce.
Observaciones — Octoparse
La consola gratuita ofrecía más de lo que esperaba del flujo de trabajo de la aplicación de escritorio. Su «AI Assistant» me permitió elegir una versión beta de «Cloud Agent» que escribe y ejecuta una herramienta de scraping personalizada. Abrí esa opción sin comprar un plan. La mantendría separada de la comparación de la programación clásica: no he verificado una cuota periódica para la beta.
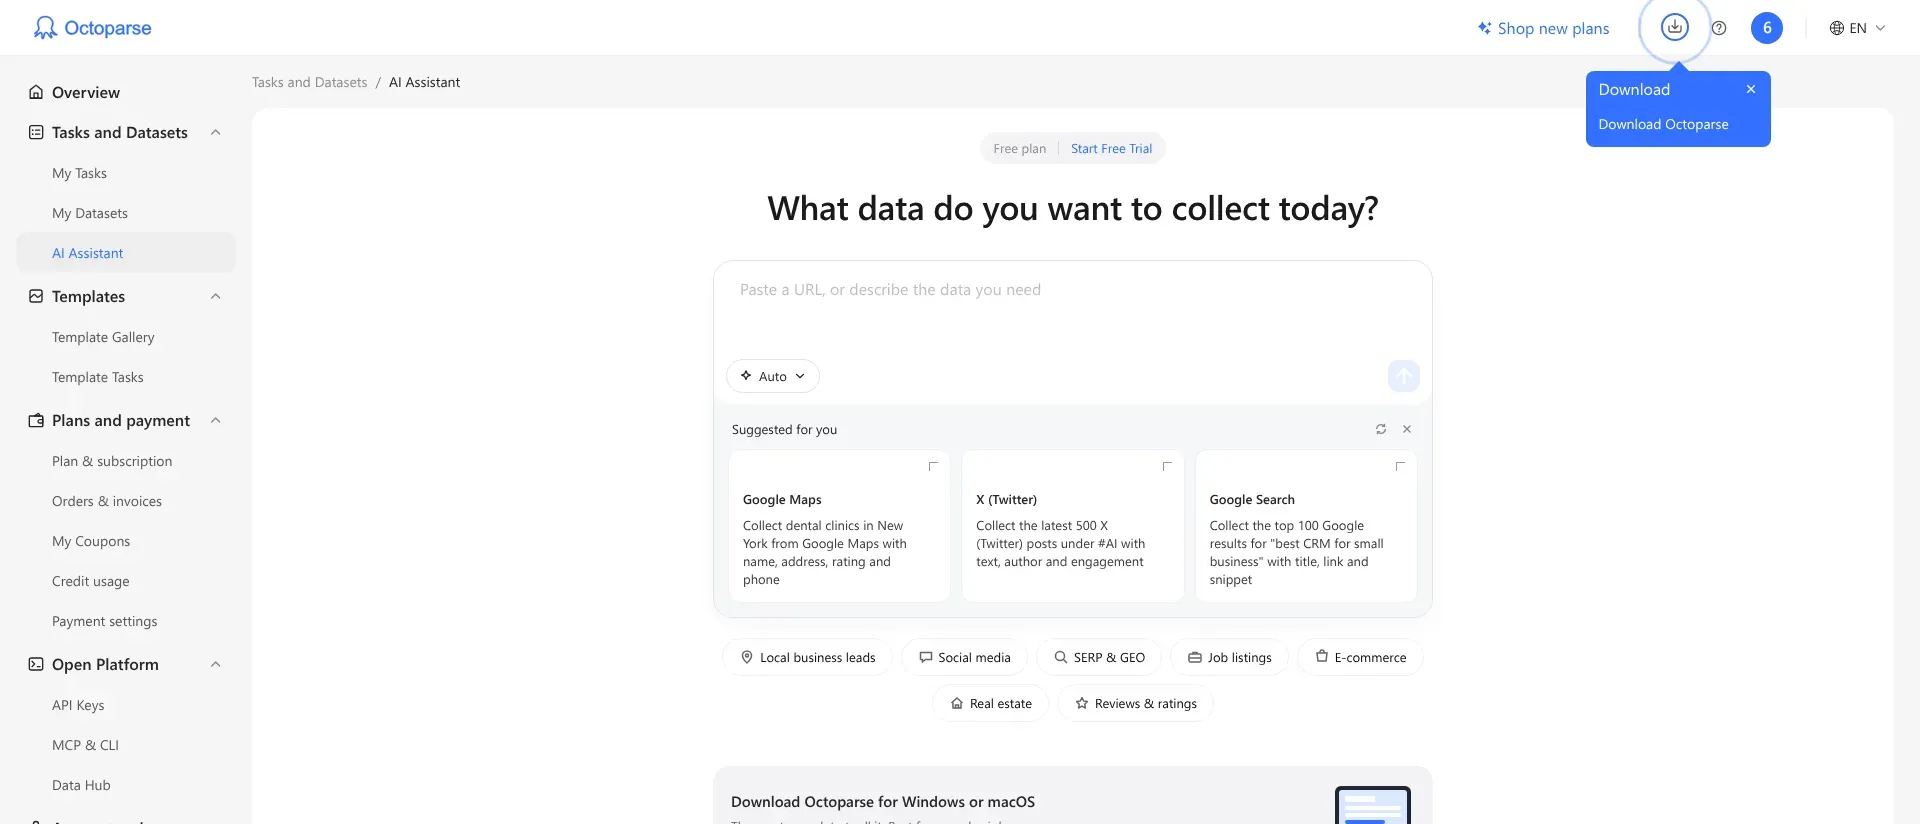
En el plan Free de Octoparse, «AI Assistant» ofrece un punto de partida basado en instrucciones junto con el flujo de trabajo de la aplicación de escritorio.
El problema es que «sin código» no elimina el mantenimiento del flujo de trabajo. Cuando una página cambia, alguien sigue teniendo que comprobar los campos seleccionados y los datos devueltos. Descartaría esta opción si prefiere una integración centrada en la API y ya dispone de un analizador; ScrapingBee encaja de forma más directa en esa tarea.
Precios de Octoparse
Desde 69 USD/mes, facturados anualmente, para Standard; plan Free disponible.
-
Free — extracción local, diez tareas y 50 000 filas de exportación mensuales.
-
Standard — 69 USD/mes, facturados anualmente, con extracción y programación en la nube.
-
Professional — 249 USD/mes, facturados anualmente, con 20 procesos simultáneos en la nube.
6. Scrapy: la mejor para rastreos personalizados con Python
Ventajas — Scrapy
-
Sin coste de licencia de software y con control sobre los selectores y el procesamiento.
-
Las exportaciones de datos integradas incluyen CSV y JSON.
Desventajas — Scrapy
-
Su equipo aporta el código, el entorno de ejecución y el mantenimiento.
-
El renderizado en navegador requiere una integración independiente cuando la página lo necesita.
Scrapy es mi elección cuando la lógica de extracción debe estar en su base de código. Escriba un spider que seleccione los campos y siga los enlaces necesarios y utilice después pipelines de procesamiento y exportaciones de datos para procesar y exportar los resultados. Esto permite gestionar las excepciones de forma deliberada en lugar de forzar cada sitio a encajar en una plantilla visual.
Ejecuté Scrapy 2.19.0 en un catálogo local y sintético que contenía tres productos. El spider exportó tanto CSV como JSON y el producto sin existencias conservó su valor cero. También fijé el orden de los campos del CSV como title, price y stock. Ninguna parte de esta comprobación requirió una cuenta ni un servicio de pago.
Observaciones — Scrapy
Una exportación correcta sigue dejando en sus manos las decisiones sobre los tipos de datos. Mis selectores devolvieron los precios y las existencias como cadenas: 12.50 y 0 se conservaron, pero el spider no los convirtió por sí solo en campos numéricos. Ese control explícito me parece útil en un flujo de procesamiento que su equipo mantiene de forma activa. Necesitará reglas de conversión y validación antes de realizar cálculos en fases posteriores.
El problema es todo lo que rodea al spider. Su equipo se ocupa del alojamiento, la programación, los reintentos adecuados para el sitio y las alertas cuando cambia el resultado. Scrapy tampoco puede renderizar por sí solo todas las páginas que dependen de JavaScript; es posible que necesite otra fuente de datos o una integración con un navegador.
Descartaría Scrapy si nadie de su equipo quiere mantener código en Python. El software gratuito puede ser una buena opción, pero no hace desaparecer el tiempo de ingeniería.
Precios de Scrapy
0 USD por la licencia del software; la ejecución y el mantenimiento son costes independientes.
-
Marco de desarrollo — de código abierto y sin cargos de software por página.
-
Operaciones — incluya en el presupuesto el alojamiento, la supervisión y el trabajo de desarrollo.
Cuánto cuesta la misma carga de trabajo
La opción más barata cambia en función del resultado y de quién ejecute la tarea. Estos son cálculos basados en los planes comprobados, no resultados de pruebas a gran escala. Los precios están expresados en USD antes de impuestos, sin acceder a sitios prémium ni utilizar proxies de pago o servicios opcionales de configuración. El tiempo de ingeniería no está incluido.
Escenario 1: una comprobación diaria y programada de un catálogo mediante una herramienta visual
Supongamos una página pública estándar compatible con la herramienta que contiene 20 filas y se recupera una vez al día durante 30 días de cada mes. Eso supone 600 filas y 30 ejecuciones mensuales. La comparación requiere una programación desatendida en la nube y una tabla configurada. Las ejecuciones locales del plan clásico Free de Octoparse no cumplen ese requisito; no se verificaron las cuotas periódicas de la beta de AI, por lo que no se le ha asignado un precio como servicio programado equivalente.
| Herramienta | Plan adecuado | Suscripción anual | Extras obligatorios para este escenario | Límite que debe vigilar |
|---|---|---|---|---|
| Browse AI | Personal, facturación anual | 228 USD por adelantado | Ninguno según los supuestos indicados | 60 créditos al mes; 720 de los 12 000 créditos anuales |
| Octoparse | Standard, facturación anual | 828 USD por adelantado | Ninguno según los supuestos indicados | Una de las 100 tareas; tres procesos en la nube |
Empezaría con Browse AI para esta pequeña tabla con actualización periódica si el robot puede entrenarse correctamente con esa página. El precio más alto de Octoparse tiene más sentido cuando también necesita su flujo de trabajo más amplio del escritorio a la nube. Antes de comprometerse con cualquiera de las dos opciones, compruebe que los campos necesarios estén en esa única página: las visitas a páginas de detalles cambian la tarea.
Escenario 2: 10 000 solicitudes mensuales de páginas HTML sin procesar
Supongamos 10 000 solicitudes de páginas procesadas correctamente con HTML sin procesar como resultado, sin renderizado de JavaScript, proxies prémium ni extracción de campos mediante AI. Su aplicación se ocupa de la programación, el análisis y el almacenamiento. Los totales se calculan a partir de doce pagos mensuales, por lo que no se mezcla ningún descuento por pago anual anticipado en la comparación.
| Herramienta | Plan adecuado | Coste durante 12 meses | Extras obligatorios incluidos | Límite que debe vigilar |
|---|---|---|---|---|
| ScrapingBee | Hobby, facturación mensual | 228 USD | Ninguno; 10 000 créditos caben en el plan | 75 000 créditos/mes; desactive JS |
| Firecrawl | Hobby más pago por uso | 528 USD | 25 USD/mes por 5000 créditos adicionales | Active el pago por uso con un límite mensual suficiente |
ScrapingBee utiliza aquí 10 000 créditos mensuales. Firecrawl alcanza los 44 USD al mes una vez incluidos los créditos adicionales; no es necesario pasar a Standard para esta carga de trabajo.
Elegiría ScrapingBee con estos supuestos. Si pasa a extraer datos en formato JSON mediante AI, vuelva a calcularlo: Firecrawl utiliza cinco créditos por página y la extracción mediante AI de ScrapingBee añade cinco créditos a la solicitud subyacente. La comparación de costes para obtener HTML básico ya no responde a su pregunta.
Apify y Scrapy necesitan una estimación diferente. Las reglas de facturación y el tiempo de ejecución de un Actor de Apify determinan su total; la licencia de Scrapy es gratuita, pero el alojamiento y el trabajo de desarrollo sí tienen un coste. No asignaría un total anual inventado a ninguna de las dos opciones sin una ejecución representativa y un plan de ejecución.
Compruebe primero las herramientas que ya utiliza
Una función de hoja de cálculo o una exportación proporcionada por la fuente puede cubrir una tarea pequeña antes de contratar otra suscripción. IMPORTHTML de Google Sheets puede importar una tabla o lista HTML por índice. El conector «Power Query From Web» de Excel permite seleccionar las tablas detectadas y transformar los resultados.
Probaría esas opciones para extraer esporádicamente una tabla sencilla. Cuando el flujo de trabajo requiera interacciones con el navegador, varias plantillas de página o una ejecución desatendida fiable, una herramienta de scraping específica resultará más útil. Compruebe también si la fuente ofrece una API adecuada o un archivo descargable: una fuente de datos ya preparada puede evitar que tenga que reconstruir su estructura a partir de una página.
Para flujos de trabajo de prospección específicos de LinkedIn, consulte la guía de automatización de Sales Navigator de Linked Helper. Es un caso de uso independiente de la extracción de datos de páginas web públicas en general.
Lecturas relacionadas:
- Las mejores herramientas de scraping de LinkedIn en 2026 (gratuitas y de pago)
- Exporte leads de LinkedIn a CSV
¿Qué herramienta de web scraping debería elegir?
| Su escenario | Mi elección | Qué determina la decisión |
|---|---|---|
| Tabla actualizada periódicamente | Browse AI | Elija en función del resultado que necesita y del trabajo que su equipo esté dispuesto a asumir. Empezaría con Browse AI para una tabla actualizada periódicamente. |
| Configuración visual de escritorio y ejecución de pago en la nube | Octoparse | Considere Octoparse cuando estas características encajen con su forma de trabajar. |
| Ya existe un Actor bien mantenido que realiza esa tarea concreta | Apify | Compruebe su conjunto de datos de muestra y sus reglas de facturación antes de decidir que el precio inicial de la plataforma representa su presupuesto total. |
| La recuperación de HTML es la pieza que falta en el proceso de un desarrollador | ScrapingBee | Elegiría ScrapingBee cuando la recuperación de HTML sea la pieza que falta. |
| La conversión de contenido es fundamental | Firecrawl | Elegiría Firecrawl cuando la conversión de contenido sea fundamental. |
| La lógica de extracción, los tipos de datos y el mantenimiento deben gestionarse en Python | Scrapy | Elegiría Scrapy cuando estos elementos deban permanecer bajo el control de mi equipo. |
Sea cual sea la opción que elija, compare una muestra pequeña con la fuente antes de programar una ejecución mayor. La prueba más útil consiste en comprobar si los campos que necesita se obtienen correctamente, incluidos los valores ausentes y la última página de resultados.
Otras herramientas que consideré
Vale la pena considerar Playwright cuando necesita programar interacciones personalizadas con el navegador. Es un marco de automatización del navegador, por lo que aún tendrá que desarrollar por separado la lógica de extracción y almacenamiento.