 Aktualisiert: 26. Oktober 2026
 21 minuten lesezeit
Eine Webseite in eine Tabelle zu übertragen, klingt nach einer kleinen Aufgabe. Dann stellen Sie fest, dass der Preis auf einer zweiten Seite steht, der kostenlose Tarif keine Ausführung zulässt, sobald Ihr Laptop ausgeschaltet ist, und „10.000 Credits“ nicht 10.000 nutzbare Datensätze bedeuten. Ich würde einen Scraper anhand solcher Details auswählen, bevor ich seinen Funktionsumfang vergleiche.
Meine Empfehlungen im Überblick
Für regelmäßig aktualisierte Tabellen ohne Code empfehle ich Browse AI; für Entwickler, die HTML über eine API abrufen möchten, ScrapingBee. Apify eignet sich für vorgefertigte Scraping-Jobs in der Cloud, Firecrawl bereitet Inhalte für AI-Anwendungen auf, Octoparse bietet visuelle Desktop-Workflows mit einer kostenpflichtigen Cloud-Option und Scrapy gibt Python-Entwicklern Kontrolle über Crawling und Ausgabe.
So habe ich die Tools geprüft – Hinweis zum Herausgeber
Ich habe den „HTML Playground“ von ScrapingBee und die öffentliche Vorschau von Firecrawl getestet, den kostenlosen AI-Workflow von Octoparse aufgerufen, einen synthetischen Katalog mit Scrapy verarbeitet und offizielle Anleitungen, Preise sowie öffentliche Nutzerbeiträge verglichen. Diese kleinen Prüfungen decken Einrichtung und Ausgabe ab, nicht die Zuverlässigkeit im Produktivbetrieb. Linked Helper veröffentlicht diesen Blog und bietet ein separates Automatisierungstool für Aktivitäten auf LinkedIn an; es gehört nicht zu den Empfehlungen.
Was ist ein Web-Scraping-Tool?
Ein Web-Scraping-Tool ruft Webseiten ab, extrahiert Inhalte und überführt sie in ein nutzbares Format wie HTML, Markdown, CSV oder JSON. Bei manchen Tools können Sie Felder visuell auswählen; andere stellen Entwicklern eine API oder ein Programmierframework bereit. Beim Crawling werden Seiten gefunden, während die Extraktion ihre Inhalte in die benötigten Datensätze umwandelt.
Die besten Web-Scraping-Tools im Überblick
| Tool | Am besten geeignet für | Besonderes Merkmal | Einstiegspreis | Wichtigster Nachteil |
|---|---|---|---|---|
| Browse AI | Regelmäßig aktualisierte Tabellen ohne Code | Visuell konfigurierte Robots und Überwachung | 19 $/Monat bei jährlicher Abrechnung; Tarif „Free“ verfügbar | Zeilen und Ausführungen verbrauchen Credits |
| Apify | Vorgefertigte Scraping-Jobs in der Cloud | Actor-Marktplatz und Datensätze | 19 $/Monat bei monatlicher Abrechnung; Tarif „Free“ verfügbar | Actor-Gebühren variieren |
| ScrapingBee | HTML über eine API | Rendering- und Proxy-Optionen | 19 $/Monat bei monatlicher Abrechnung | Sie erstellen den Datenworkflow selbst |
| Firecrawl | Inhalte für AI-Anwendungen | Markdown und strukturierte Formate | 19 $/Monat bei monatlicher Abrechnung; Tarif „Free“ verfügbar | JSON verbraucht zusätzliche Credits |
| Octoparse | Visuelle Workflows vom Desktop in die Cloud | Lokale Extraktion und kostenpflichtige zeitgesteuerte Cloud-Ausführung | 69 $/Monat bei jährlicher Abrechnung; Tarif „Free“ verfügbar | Die klassische zeitgesteuerte Cloud-Ausführung erfordert einen kostenpflichtigen Tarif |
| Scrapy | Individuelle Python-Crawls | Selektoren, Pipelines und Feed-Exporte | 0 $ Lizenzkosten | Sie warten das System selbst |
Was zeichnet die besten Web-Scraping-Tools aus?
Ein nützlicher Scraper stellt die benötigten Felder in einem für den nächsten Arbeitsschritt geeigneten Format bereit – zu kalkulierbaren Kosten. Ich würde mit einer repräsentativen Seite beginnen. Testen Sie dabei auch den anspruchsvollsten Teil des Workflows: Paginierung, fehlende Preise oder Felder, die erst nach einem Klick erscheinen.
Die Ausgabe, die Sie tatsächlich benötigen. HTML ist nützlich, wenn Sie einen Parser schreiben. Markdown ist nützlich, wenn eine AI-Anwendung lesbare Seiteninhalte benötigt. Für eine Tabelle benötigen Sie eine konsistente Spaltenstruktur. Bezahlen Sie nicht für eine Formatkonvertierung, die Sie sofort wieder rückgängig machen.
Wo sich die Daten befinden. Zwanzig Produkte auf einer Übersichtsseite und zwanzig einzelne Produktseiten erfordern einen unterschiedlich hohen Arbeitsaufwand. Prüfen Sie, ob das Tool jede Detailseite abrufen, JavaScript rendern oder weiteren Links folgen muss.
Wer den Betrieb sicherstellt. Ein kostenloses Desktop-Tool kann für einen monatlichen Export genügen, den Sie beaufsichtigen. Für eine täglich ausgeführte Aufgabe benötigen Sie eine Ausführungsumgebung, eine Zeitsteuerung und eine Möglichkeit, fehlende Ergebnisse zu erkennen. Cloud-Hosting reduziert einen Teil des Aufwands; die Kontrolle Ihrer Daten bleibt trotzdem erforderlich.
Eine nachvollziehbare Rechnung. Achten Sie auf die Kosten pro Anfrage, Zeile, Event oder Compute Unit. Prüfen Sie anschließend die Zusatzkosten für die Einstellungen, die Sie verwenden werden. Durch zusätzliche Optionen kann aus einer günstigen Basisanfrage ein teurer browsergestützter Abruf oder ein AI-gestützter Verarbeitungsschritt werden.
Ein kleines, überprüfbares Ergebnis. Bevor ich eine zeitgesteuerte Ausführung einrichte, möchte ich einige zurückgegebene Felder mit der Quelle vergleichen. Ein erfolgreicher HTTP-Statuscode zeigt, dass eine Anfrage abgeschlossen wurde; er sagt nicht aus, ob tatsächlich alle erwarteten Produkte erfasst wurden.
Die sechs Empfehlungen umfassen visuelle Tools, gehostete APIs und individuellen Code. Datenlieferverträge für Großunternehmen und spezialisierte Tools für soziale Plattformen decken spezifischere Anforderungen ab. Daher behandle ich sie hier nicht als vergleichbare Alternativen.
1. Browse AI: am besten für regelmäßig aktualisierte Tabellen ohne Code
Vorteile – Browse AI
-
Visuell konfigurierte Robots unterstützen sowohl die Überwachung als auch wiederholbare Extraktionsabläufe.
-
Der Bereich „Table Studio“ schlägt anhand einer URL Felder vor, ohne eine Browsererweiterung zu erfordern.
Nachteile – Browse AI
-
Separate Ausführungen für Detailseiten können deutlich mehr Credits verbrauchen als eine einzige Extraktion von einer Übersichtsseite.
-
Das Kontingent von 50 Credits im Tarif „Free“ ist für die tägliche Überwachung knapp.
Browse AI ist meine Empfehlung, wenn Ihr Ziel eine regelmäßig aktualisierte Tabelle ist und Sie keine Selektoren im Code warten möchten. Als Ausgangspunkt für den Bereich „Table Studio“ dient die URL einer Seite. Daraufhin schlägt er Spalten und Beispielzeilen vor. Sie prüfen die Felder, wählen die Anzahl der zu erfassenden Elemente und speichern anschließend den Robot für wiederholte Ausführungen.
Mir gefällt die Trennung zwischen dem Aufbau einer Tabelle und ihrer zeitgesteuerten Ausführung. Wenn Sie einen Lieferantenkatalog beobachten, können Sie sich auf die benötigten Spalten konzentrieren und müssen nicht an die Anfrage denken, mit der jede Seite abgerufen wird. „Table Studio“ befindet sich allerdings noch in der Betaphase und interaktive Abläufe gehören in den Bereich „Robot Studio“: Das Durchklicken eines Formulars ist eine andere Aufgabe als das Auslesen einer bereits sichtbaren Liste.
Was mir aufgefallen ist – Browse AI
Ich würde zuerst Seitenabrufe und erst danach Zeilen zählen. Nach den üblichen Credit-Regeln kosten 20 Elemente auf einer Übersichtsseite zwei Credits. Wird ein Robot separat auf 20 Detailseiten ausgeführt, kostet dies mindestens 20 Credits – noch bevor eine Ausführung zur Ermittlung dieser Links berücksichtigt wird. Bei derselben Anzahl von Elementen ist das ein zehnfacher Unterschied.
Der Haken ist, wie schnell wiederholte Ausführungen das kostenlose Kontingent aufbrauchen. Die tägliche Extraktion einer Liste mit 20 Zeilen verbraucht in einem Monat mit 30 Tagen 60 Credits und liegt damit knapp über dem Kontingent von 50 Credits im Tarif „Free“. Ich würde darauf verzichten, wenn Ihr Team ohnehin einen eigenen Parser schreiben und jede Anfrage kontrollieren möchte; dann bezahlen Sie für einen visuellen Workflow, den Sie möglicherweise nicht benötigen.
Preise von Browse AI
Ab 19 $/Monat bei jährlicher Abrechnung für den Tarif „Personal“; Tarif „Free“ verfügbar.
-
„Free“ – 50 Credits/Monat für zwei Websites.
-
„Personal“ – 19 $/Monat bei jährlicher Abrechnung, wobei jährlich 12.000 Credits im Voraus bereitgestellt werden.
-
„Professional“ – 69 $/Monat bei jährlicher Abrechnung, mit 60.000 Credits pro Jahr und zehn Websites.
2. Apify: am besten für vorgefertigte Scraping-Jobs in der Cloud
Vorteile – Apify
-
Website-spezifische Actors können Ihnen ersparen, einen Extraktor von Grund auf zu entwickeln.
-
Datensätze unterstützen unter anderem CSV, JSON und Excel.
Nachteile – Apify
-
Jeder Actor hat eigene Eingabeanforderungen und ein eigenes Abrechnungsmodell.
-
Plattform-Credits lassen sich nicht in eine feste Anzahl von Zeilen umrechnen.
Apify ist einen Blick wert, wenn ein vorgefertigter Actor Ihre Zielwebsite oder Ihren Workflow bereits abdeckt. Ein Actor ist ein Programm, das Sie in der Cloud von Apify ausführen können; dabei kann es sich um einen spezialisierten Scraper oder ein allgemeineres Tool handeln, das zusätzliche Konfiguration erfordert. Entscheidend ist, ob der jeweilige Actor die von Ihnen benötigten Felder zurückgibt.
Mir gefällt, dass Ausführung und Zugriff auf Datensätze auf derselben Plattform verfügbar sind. Sie können mit einem passenden Actor beginnen, dessen Beispielausgabe prüfen und anschließend dafür sorgen, dass eine andere Anwendung den Datensatz nutzt. Das ist ein sinnvollerer Ausgangspunkt, als Infrastruktur zu kaufen, bevor Sie einen funktionierenden Extraktor gefunden haben.
Die Auswahl des Actors erfordert dennoch Sorgfalt. In einer Diskussion auf r/scrapingtheweb vom September 2026 schrieb u/Heiswasistocome: “I am looking at Apify and feeling overwhelmed at the number of actors who can do what I want them to do.” Ich würde die Suche anhand der Ausgabefelder, des aktuellen Wartungsstands und einer kleinen Beispielausführung eingrenzen, anstatt mich ausschließlich an der Beliebtheit zu orientieren.
Der Haken ist die Preisgestaltung auf zwei Ebenen. Bei Actors kann nach Events oder Nutzung abgerechnet werden, wobei die Plattformkosten je nach Actor enthalten sind oder separat anfallen. Apifys „Compute Unit“ entspricht einem Gigabyte Arbeitsspeicher, das eine Stunde lang genutzt wird; sie sagt nicht aus, wie viele Produkte Sie erhalten. Ich würde Apify nicht wählen, wenn Sie einen universellen Preis pro Seite für voneinander unabhängige Scraper erwarten.
Ein Detail sollten Sie vor dem Export prüfen, bevor Sie eine nachgelagerte Tabelle entwerfen: Beim Auswählen von Datensatzfeldern sind nur Namen der obersten Ebene zulässig; auszuschließende Felder können dagegen über verschachtelte Pfade angegeben werden. Ein verschachteltes Ergebnis muss möglicherweise umstrukturiert werden, bevor daraus die gewünschte flache Tabelle wird.
Preise von Apify
Ab 19 $/Monat bei monatlicher Abrechnung für den Tarif „Starter“, zuzüglich der Nutzung über den enthaltenen Betrag hinaus; Tarif „Free“ verfügbar.
-
„Free“ – Plattformnutzung im Wert von 5 $ pro Monat.
-
„Starter“ – die monatliche Abonnementgebühr steht vollständig als Nutzungsguthaben zur Verfügung.
-
Actor-Gebühren – prüfen Sie die Event-Gebühren, die nutzungsabhängigen Kosten und die enthaltenen Plattformkosten des ausgewählten Actors separat.
3. ScrapingBee: am besten für den Abruf von HTML über eine API
Vorteile – ScrapingBee
-
Einfache HTML-Anfragen können jeweils einen Credit kosten.
-
Rendering, Proxy-Auswahl und Extraktionsoptionen sind über eine API zugänglich.
Nachteile – ScrapingBee
-
Die Einstellungen verändern die Credit-Kosten pro Anfrage.
-
Zeitsteuerung, Speicherung und nachgelagerte Validierung bleiben Ihre Aufgabe.
ScrapingBee ist meine Empfehlung für Entwickler, die den Seitenabruf auslagern möchten, ohne eine vollständige visuelle Datenplattform zu erwerben. Sie senden eine URL und eine Konfiguration und verarbeiten die Antwort anschließend in Ihrer eigenen Anwendung. Das passt zu einer bestehenden Pipeline, in der bereits feststeht, wie die Ergebnisse geparst, gespeichert und geprüft werden sollen.
Ich habe den „HTML Playground“ mit einer Seite der Sandbox „Books to Scrape“ getestet. Bei deaktiviertem „Auto mode“ und ausgeschaltetem JavaScript-Rendering lieferte die Anfrage den HTTP-Statuscode 200 und die Benutzeroberfläche zeigte den Abzug eines Credits an. Das war eine nützliche Konfigurationsprüfung; eine einfache Demoseite sagt jedoch wenig über schwierige Websites aus.
Was mir aufgefallen ist – ScrapingBee
Prüfen Sie die Einstellungen, bevor Sie die Anfrage starten. Der „HTML Playground“ wurde zunächst mit aktiviertem „Auto mode“ geöffnet. Nachdem ich „Auto mode“ deaktiviert hatte, war JavaScript-Rendering weiterhin separat ausgewählt. Durch dessen Deaktivierung erhielt ich die gewünschte Konfiguration mit einem Credit. Die Standardeinstellung der API für JavaScript-Rendering kostet fünf Credits, während eine einfache Anfrage ohne Rendering einen Credit kostet.
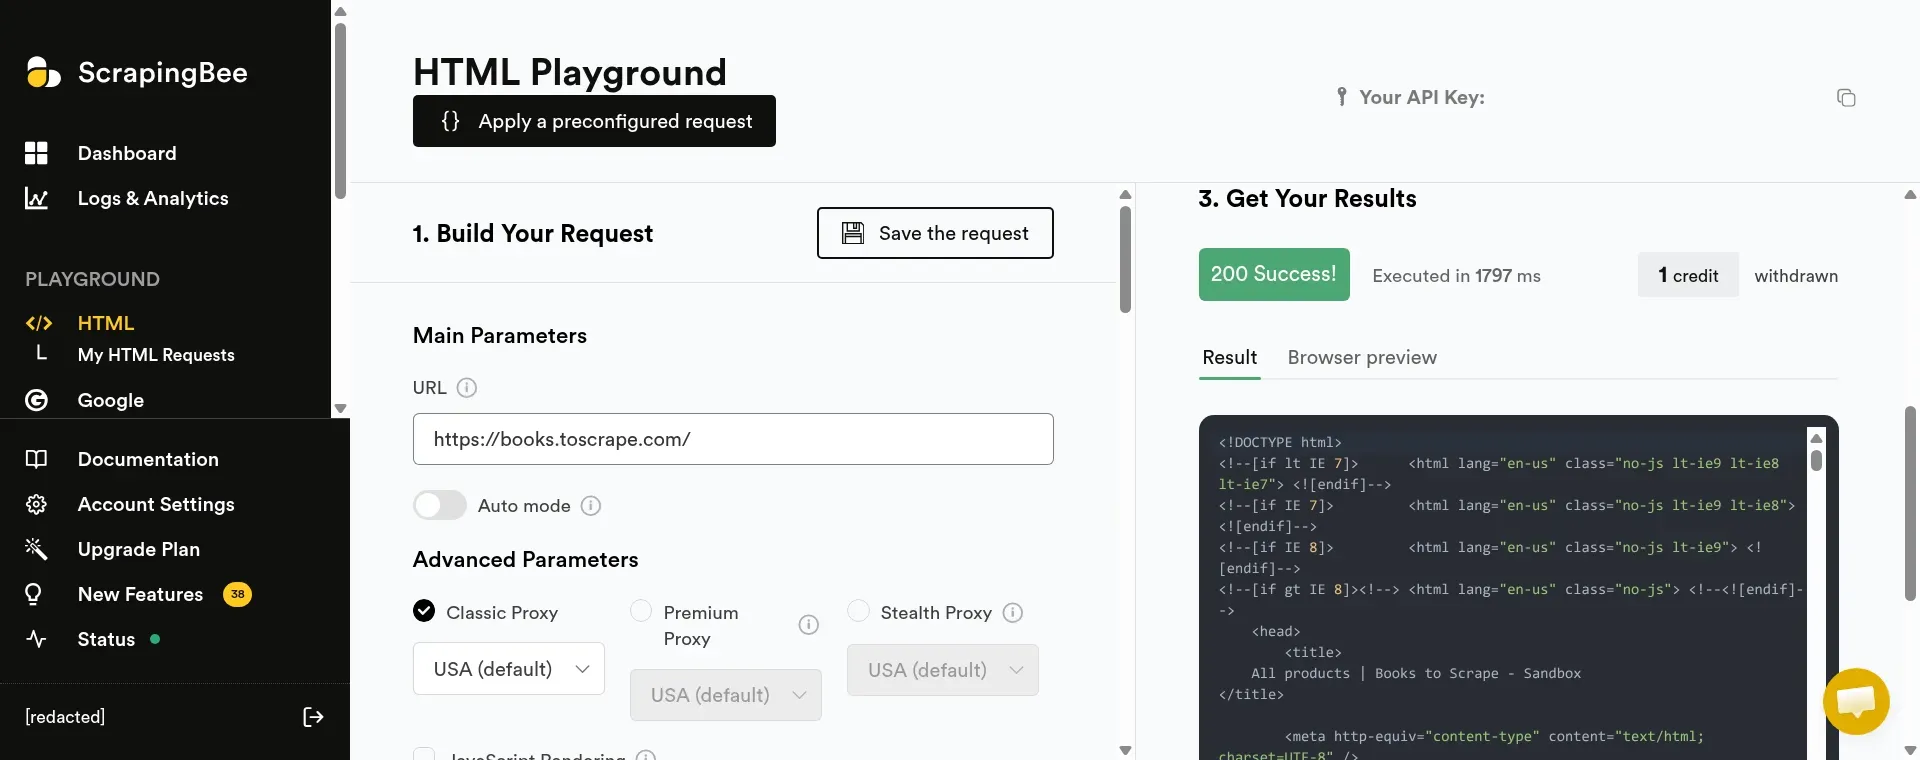
Im „HTML Playground“ von ScrapingBee lieferte die Anfrage für die einfache Seite ein Ergebnis und zeigte den Abzug eines Credits an.
Diese Kontrolle gefällt mir bei Seiten, die keinen Browser benötigen, weil Sie nicht für unnötiges Rendering bezahlen müssen. Der Haken ist, dass Sie die abgerufene Seite weiterhin in zuverlässige Datensätze umwandeln müssen. Ich würde darauf verzichten, wenn Sie eine fertige Überwachungstabelle wünschen, ohne einen Workflow rund um die API aufzubauen.
Preise von ScrapingBee
Ab 19 $/Monat bei monatlicher Abrechnung für den Tarif „Hobby“; ein Testkontingent von 1.000 Credits ist verfügbar.
-
„Hobby“ – 19 $/Monat für 75.000 Credits und 25 gleichzeitige Anfragen.
-
„Freelance“ – 49 $/Monat für 250.000 Credits und 50 gleichzeitige Anfragen.
-
Anfrageeinstellungen – Standard-HTML kostet einen Credit, JavaScript-Rendering fünf Credits; Premiumoptionen kosten mehr.
4. Firecrawl: am besten für Inhalte, die AI-Anwendungen verarbeiten
Vorteile – Firecrawl
-
Gibt Markdown, HTML und strukturierte Extraktionsformate zurück.
-
Im öffentlichen „Playground“ können Sie eine Seite testen und eine Vorschau prüfen.
Nachteile – Firecrawl
-
Die strukturierte JSON-Extraktion verbraucht zusätzlich zu den Basiskosten der Seite weitere Credits.
-
Eine erfolgreiche Vorschau ersetzt nicht die Prüfung der vollständigen Ausgabe.
Firecrawl ist meine Empfehlung, wenn Ihr nächster Arbeitsschritt lesbare Seiteninhalte statt Roh-HTML benötigt. Markdown eignet sich für Retrieval- und AI-Workflows; strukturiertes JSON ist sinnvoll, wenn ein nachgelagerter Prozess benannte Felder erwartet. Mir gefällt, dass diese Optionen an einem Ort verfügbar sind, aber ich würde die benötigte Ausgabe festlegen, bevor ich die Kosten schätze.
Ich habe die Seite der Sandbox „Books to Scrape“ im öffentlichen „Playground“ übermittelt und eine erfolgreiche Markdown-Vorschau erhalten. Der Link „Home“ und die Überschrift „All products“ blieben erhalten. Für die vollständige Ausgabe war ein Konto erforderlich, sodass meine Prüfung bei dieser Vorschau endete und keinen verifizierten Export aller Produkte umfasste.
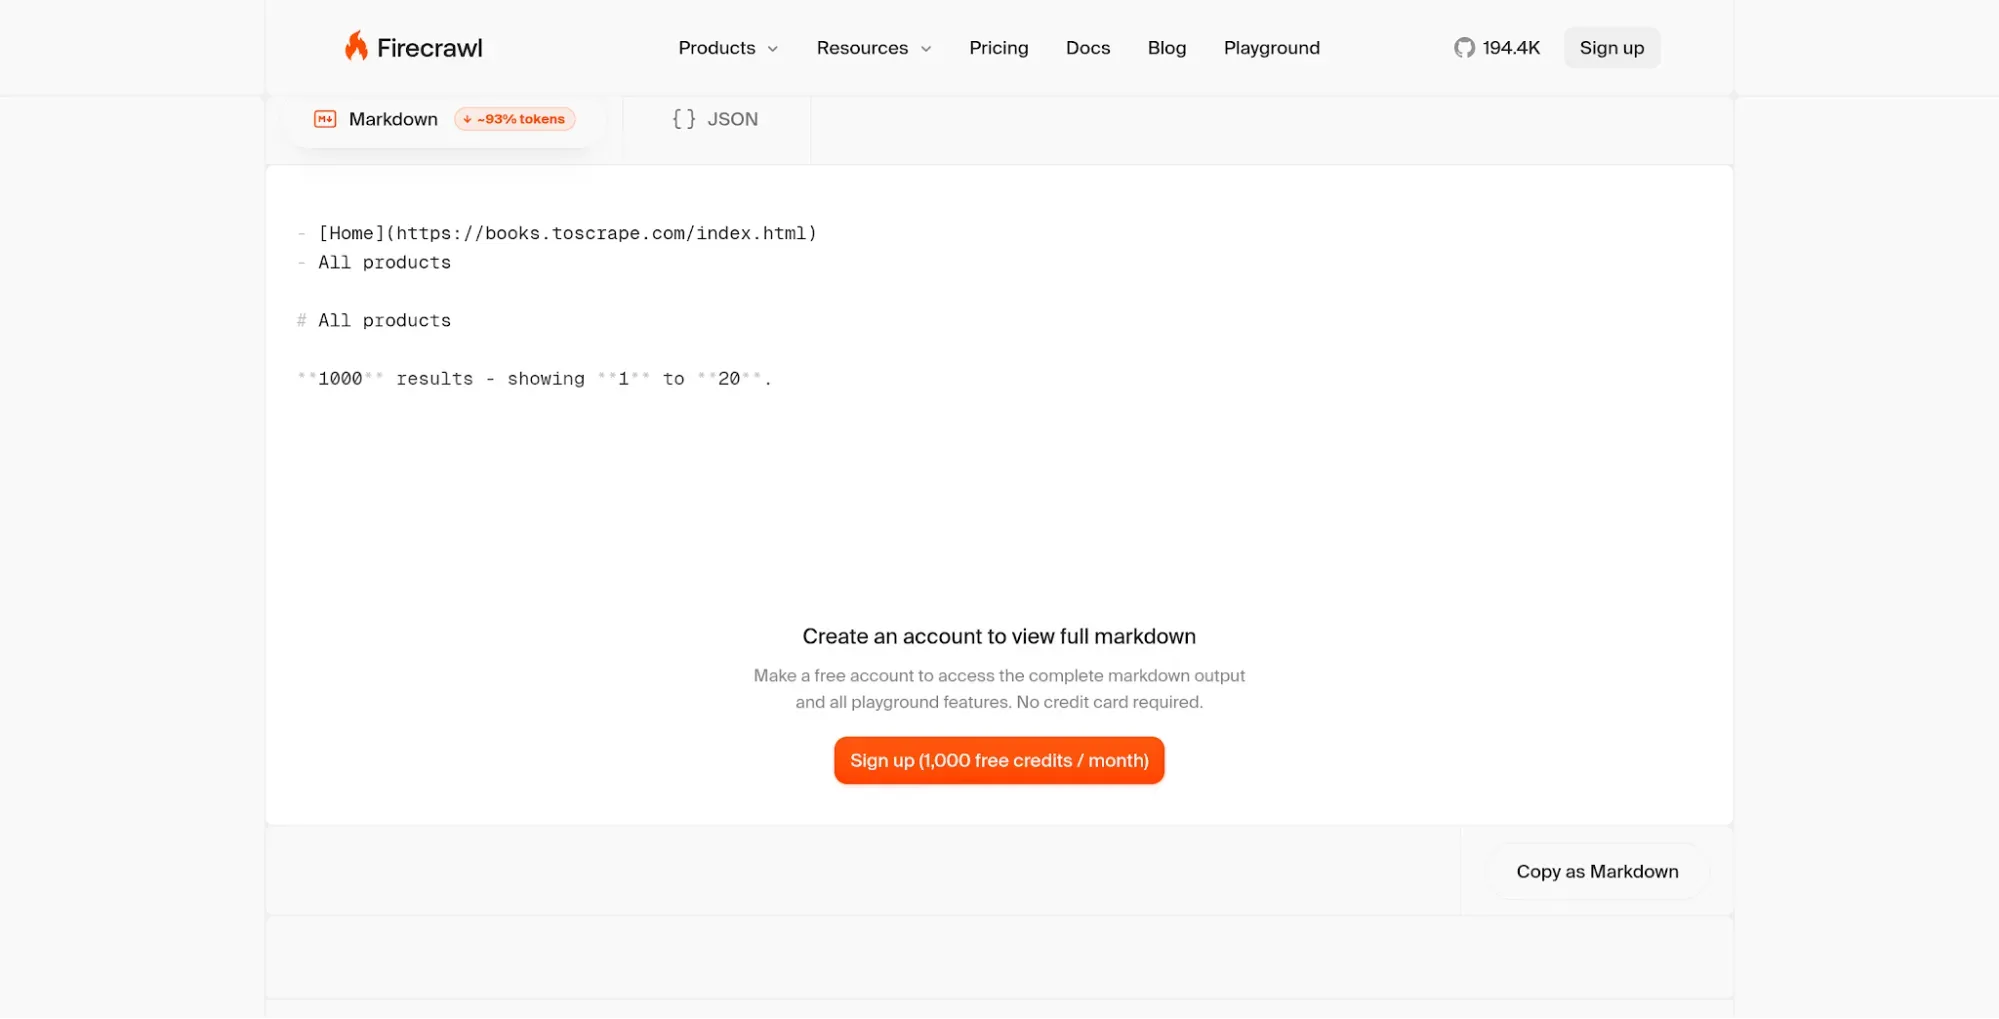
Im öffentlichen „Playground“ von Firecrawl behält die Markdown-Vorschau die Navigation und eine Seitenüberschrift bei; für die vollständige Ausgabe ist ein Konto erforderlich.
Dieses kleine Detail ist wichtig: Lesbares Markdown ist nicht automatisch eine Tabelle mit bereinigten Produktfeldern. Wenn Sie einen Katalog in eine Datenbank einspeisen, benötigen Sie weiterhin ein Schema und Prüfungen auf fehlende Werte. Wenn Sie einer AI-Anwendung Seiteninhalte als Kontext bereitstellen, kann eine umfassendere Darstellung des Seiteninhalts genau das Richtige sein.
Der Haken ist der höhere Credit-Verbrauch je nach Ausgabeformat. Ein einfacher Scraping-Vorgang kostet einen Credit pro Seite; mit zusätzlicher JSON-Extraktion steigt der Verbrauch auf fünf. In einem Beitrag auf r/automation vom September 2026 lobte u/Rankspartanben den Support von Firecrawl, bezeichnete das Tool aber als “quite expensive”. Ich würde dies als Anlass nehmen, die Kosten für Ihr eigenes Format und Volumen zu berechnen, und nicht als Grund, das Tool abzulehnen.
Ich würde Firecrawl nicht wählen, wenn Sie Daten lediglich gelegentlich per Mausklick als CSV extrahieren möchten. Seine Konvertierungs- und API-Funktionen sind sinnvoller, wenn Sie eine wiederholbare Pipeline zur Inhaltsverarbeitung aufbauen.
Preise von Firecrawl
Ab 19 $/Monat bei monatlicher Abrechnung für den Tarif „Hobby“; Tarif „Free“ verfügbar.
-
„Free“ – 1.000 Credits, die monatlich neu gutgeschrieben werden.
-
„Hobby“ – 19 $/Monat für 5.000 monatliche Credits; zusätzliche Credits kosten 5 $ pro 1.000.
-
„Standard“ – 99 $/Monat für 100.000 monatliche Credits.
5. Octoparse: am besten für visuelle Workflows vom Desktop in die Cloud
Vorteile – Octoparse
-
Mit der kostenlosen lokalen Extraktion können Sie ohne Abonnement beginnen.
-
Der Tarif „Standard“ ergänzt Cloud-Extraktion, Zeitsteuerung und eine Datenexport-API.
Nachteile – Octoparse
-
Die klassische zeitgesteuerte Cloud-Ausführung erfordert einen kostenpflichtigen Tarif; für die AI-Betaversion gelten andere Kontingente.
-
Optionale Proxy- und Einrichtungsdienste können den Tarifpreis erhöhen.
Octoparse ist eine Überlegung wert, wenn Sie Extraktionsworkflows visuell erstellen und die Möglichkeit behalten möchten, sie in der Cloud auszuführen. Sie können mit Vorlagen, dem „AI Assistant“ oder der Desktop-Anwendung beginnen. Die kostenpflichtigen klassischen Tarife bieten zusätzliche Cloud-Kapazität und eine Zeitsteuerung für Aufgaben, die nicht an Ihren eigenen Computer gebunden sein sollen.
Die Unterscheidung zwischen lokaler und Cloud-Ausführung gefällt mir, weil sie eine praktische Grundlage für die Kaufentscheidung bietet. Wenn Sie einmal im Monat an Ihrem Schreibtisch einen Katalog exportieren, kann die kostenlose lokale Option ausreichen. Muss derselbe Katalog jeden Morgen aktualisiert werden, ist die Zeitsteuerung im Tarif „Standard“ die Funktion, für die Sie tatsächlich bezahlen.
Beim klassischen Desktop-Ansatz umfasst der Tarif „Free“ zehn Aufgaben, ein Gerät und 50.000 Exportzeilen pro Monat, mit bis zu 10.000 Zeilen pro Export. Der Tarif „Standard“ erhöht das Aufgabenkontingent auf 100 und umfasst bis zu drei gleichzeitige Cloud-Prozesse. Diese Zahlen messen unterschiedliche Dinge: Eine Aufgabe ist ein gespeicherter Workflow, während die exportierten Zeilen die von ihm erzeugten Daten darstellen.
Was mir aufgefallen ist – Octoparse
Die kostenlose Konsole bot mehr als nur den erwarteten Desktop-Workflow. Mit dem „AI Assistant“ konnte ich einen „Cloud Agent“ in der Betaversion auswählen, der einen individuellen Scraper schreibt und ausführt. Ich habe diese Option aufgerufen, ohne einen Tarif zu kaufen. Ich würde sie getrennt vom Vergleich der klassischen Zeitsteuerungsfunktionen betrachten: Ein wiederkehrendes Kontingent für die Betaversion habe ich nicht überprüft.
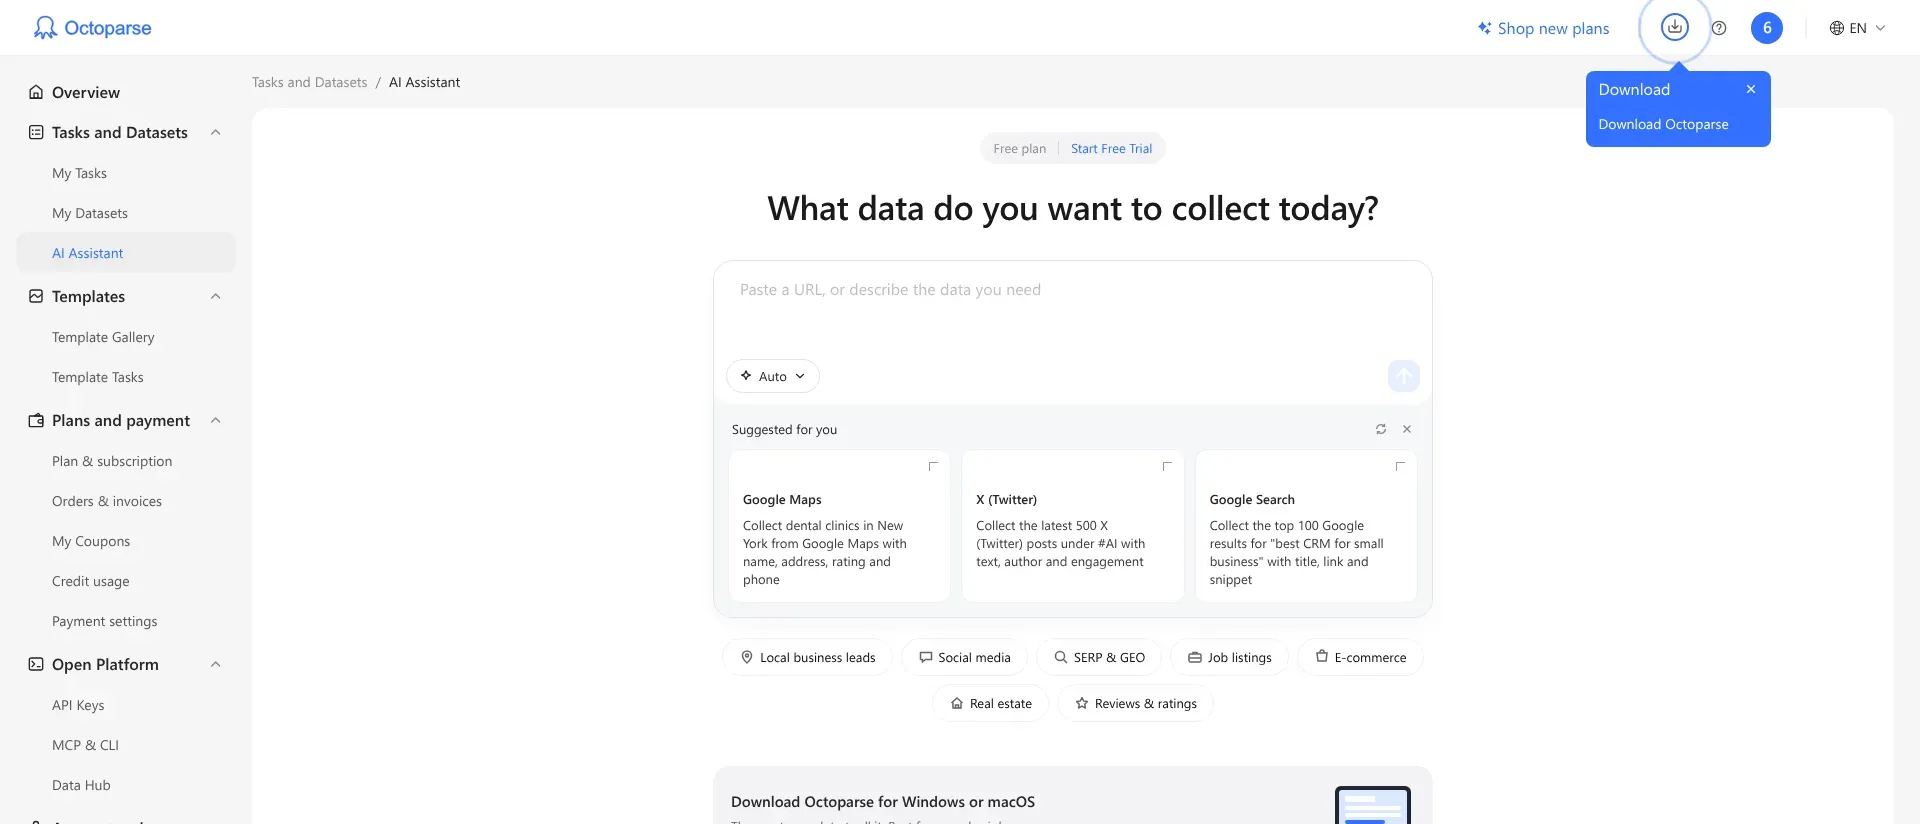
Im Tarif „Free“ von Octoparse bietet der „AI Assistant“ neben dem Desktop-Workflow einen Einstieg über eine Texteingabe.
Der Haken ist, dass ein Workflow ohne Code dennoch gewartet werden muss. Wenn sich eine Seite ändert, muss weiterhin jemand die ausgewählten Felder und die zurückgegebenen Daten prüfen. Ich würde darauf verzichten, wenn Sie eine API-orientierte Integration bevorzugen und bereits einen Parser besitzen; für diese Aufgabe ist ScrapingBee die direktere Lösung.
Preise von Octoparse
Ab 69 $/Monat bei jährlicher Abrechnung für den Tarif „Standard“; Tarif „Free“ verfügbar.
-
„Free“ – lokale Extraktion, zehn Aufgaben und 50.000 monatliche Exportzeilen.
-
„Standard“ – 69 $/Monat bei jährlicher Abrechnung, mit Cloud-Extraktion und Zeitsteuerung.
-
„Professional“ – 249 $/Monat bei jährlicher Abrechnung, mit 20 gleichzeitigen Cloud-Prozessen.
6. Scrapy: am besten für individuelle Python-Crawls
Vorteile – Scrapy
-
Keine Softwarelizenzgebühr und Kontrolle über Selektoren und Verarbeitung.
-
Integrierte Feed-Exporte umfassen CSV und JSON.
Nachteile – Scrapy
-
Sie sind selbst für Code, Ausführungsumgebung und Wartung verantwortlich.
-
Browser-Rendering erfordert eine separate Integration, wenn die Seite darauf angewiesen ist.
Scrapy ist meine Empfehlung, wenn die Extraktionslogik in Ihre Codebasis gehört. Sie schreiben einen Spider, der die benötigten Felder auswählt und den erforderlichen Links folgt, und verwenden anschließend Pipelines und Feeds, um die Ergebnisse zu verarbeiten und zu exportieren. So können Sie Ausnahmen gezielt behandeln, anstatt jede Website in eine visuelle Vorlage zu pressen.
Ich habe Scrapy 2.19.0 mit einem lokalen, synthetischen Katalog ausgeführt, der drei Produkte enthielt. Der Spider exportierte sowohl CSV als auch JSON, und der Lagerbestand von 0 wurde unverändert übernommen. Außerdem habe ich die Reihenfolge der CSV-Felder auf title, price und stock festgelegt. Für diesen Test waren weder ein Konto noch ein kostenpflichtiger Dienst erforderlich.
Was mir aufgefallen ist – Scrapy
Auch bei einem erfolgreichen Export müssen Sie Entscheidungen zu den Datentypen treffen. Meine Selektoren gaben Preise und Lagerbestand als Zeichenfolgen zurück: „12.50“ und „0“ blieben erhalten, aber der Spider wandelte sie nicht selbstständig in numerische Felder um. Diese explizite Kontrolle gefällt mir bei einer dauerhaft gepflegten Pipeline. Bevor Sie nachgelagerte Berechnungen vornehmen, sollten Sie Regeln für Konvertierung und Validierung festlegen.
Der eigentliche Aufwand entsteht durch den Betrieb rund um den Spider. Sie sind für Hosting, Zeitsteuerung, für die Website geeignete Wiederholungsversuche bei Fehlern und Warnmeldungen bei Veränderungen der Ausgabe verantwortlich. Scrapy rendert beliebige JavaScript-Seiten zudem nicht eigenständig; möglicherweise benötigen Sie eine andere Datenquelle oder eine Browserintegration.
Ich würde Scrapy nicht wählen, wenn niemand in Ihrem Team Python-Code pflegen möchte. Kostenlose Software kann wirtschaftlich sein, erspart Ihnen jedoch nicht den Entwicklungsaufwand.
Preise von Scrapy
0 $ Lizenzkosten; Ausführung und Wartung verursachen separate Kosten.
-
Framework – Open Source, ohne Softwaregebühr pro Seite.
-
Betrieb – kalkulieren Sie die Kosten für Hosting, Überwachung und Entwicklung ein.
Was dasselbe Nutzungsszenario kostet
Die günstigste Wahl hängt von der Ausgabe und davon ab, wer die Aufgabe ausführt. Die folgenden Werte sind Berechnungen auf Grundlage der geprüften Tarife und keine Ergebnisse groß angelegter Tests. Die Preise verstehen sich in USD vor Steuern und ohne Premium-Websites, kostenpflichtige Proxys oder optionale Einrichtungsdienste. Entwicklungszeit ist nicht berücksichtigt.
Szenario 1: Eine täglich ausgeführte Katalogprüfung mit visueller Konfiguration
Angenommen wird eine unterstützte, öffentlich zugängliche Standardseite mit 20 Zeilen, die jeden Tag und damit 30-mal pro Monat abgerufen wird. Das ergibt monatlich 600 Zeilen und 30 Ausführungen. Der Vergleich setzt eine unbeaufsichtigte zeitgesteuerte Cloud-Ausführung und eine konfigurierte Tabelle voraus. Die klassischen lokalen Ausführungen im Tarif „Free“ von Octoparse erfüllen diese Anforderung nicht. Da ich die wiederkehrenden Kontingente der AI-Betaversion nicht überprüfen konnte, berücksichtige ich diese Option nicht als gleichwertigen zeitgesteuerten Dienst.
| Tool | Geeigneter Tarif | Jährliche Abonnementkosten | Erforderliche Zusatzkosten für dieses Szenario | Zu beachtende Grenze |
|---|---|---|---|---|
| Browse AI | „Personal“, jährliche Abrechnung | 228 $ im Voraus | Unter den genannten Annahmen keine | 60 Credits/Monat; 720 von 12.000 Credits pro Jahr |
| Octoparse | „Standard“, jährliche Abrechnung | 828 $ im Voraus | Unter den genannten Annahmen keine | Eine von 100 Aufgaben; drei Cloud-Prozesse |
Für diese kleine, regelmäßig aktualisierte Tabelle würde ich mit Browse AI beginnen, sofern sich der Robot problemlos für die Seite konfigurieren lässt. Octoparse kann sich trotz des höheren Preises eher lohnen, wenn Sie zusätzlich dessen umfassendere Workflows vom Desktop in die Cloud benötigen. Prüfen Sie vor der Entscheidung für eines der Tools, ob sich alle benötigten Felder auf dieser einen Seite befinden: Zusätzliche Abrufe von Detailseiten verändern den Aufwand.
Szenario 2: 10.000 einfache HTML-Seitenanfragen pro Monat
Angenommen werden 10.000 erfolgreiche Seitenanfragen mit Roh-HTML-Ausgabe, ohne JavaScript-Rendering, Premium-Proxys oder AI-Feldextraktion. Ihre Anwendung übernimmt Zeitsteuerung, Parsing und Speicherung. Die Gesamtbeträge basieren auf zwölf monatlichen Zahlungen, sodass kein Rabatt für jährliche Vorauszahlung in den Vergleich einfließt.
| Tool | Geeigneter Tarif | Kosten über 12 Monate | Erforderliche Zusatzkosten | Zu beachtende Grenze |
|---|---|---|---|---|
| ScrapingBee | „Hobby“, monatliche Abrechnung | 228 $ | Keine; 10.000 Credits passen in den Tarif | 75.000 Credits/Monat; JS deaktivieren |
| Firecrawl | „Hobby“ plus „Pay-as-you-go“ | 528 $ | 25 $/Monat für 5.000 zusätzliche Credits | „Pay-as-you-go“ mit einem ausreichenden monatlichen Kontingent aktivieren |
ScrapingBee verbraucht hier 10.000 Credits pro Monat. Firecrawl erreicht einschließlich der zusätzlichen Credits 44 $ pro Monat; ein Wechsel zum Tarif „Standard“ ist für dieses Nutzungsszenario nicht erforderlich.
Unter diesen Annahmen würde ich ScrapingBee wählen. Wenn Sie statt HTML mithilfe von AI extrahiertes JSON benötigen, müssen Sie neu rechnen: Firecrawl verbraucht fünf Credits pro Seite und bei ScrapingBee kommen für die AI-Extraktion fünf Credits zur zugrunde liegenden Anfrage hinzu. Der günstige HTML-Vergleich beantwortet Ihre Frage dann nicht mehr.
Apify und Scrapy erfordern eine andere Kalkulation. Die Abrechnungsregeln und die Laufzeit eines Apify-Actors bestimmen dessen Gesamtkosten; die Lizenz von Scrapy ist kostenlos, Hosting und Arbeitsaufwand sind es jedoch nicht. Ohne eine repräsentative Ausführung und einen Ausführungsplan würde ich für keines der beiden Tools einen erfundenen Jahresbetrag ansetzen.
Prüfen Sie zuerst Ihren bestehenden Technologie-Stack
Eine Tabellenfunktion oder ein von der Quelle bereitgestellter Export kann eine kleine Aufgabe abdecken, bevor Sie ein weiteres Abonnement abschließen. IMPORTHTML in Google Sheets kann eine HTML-Tabelle oder Liste anhand ihres Index abrufen. Mit der Power-Query-Funktion „Aus dem Web“ in Excel können Sie erkannte Tabellen auswählen und die Ergebnisse transformieren.
Ich würde diese Möglichkeiten für eine gelegentliche, unkomplizierte Tabelle ausprobieren. Sobald der Workflow Browserinteraktionen, mehrere Seitenvorlagen oder eine zuverlässige unbeaufsichtigte Ausführung erfordert, lohnt sich zunehmend der Einsatz eines spezialisierten Scrapers. Prüfen Sie außerdem, ob die Quelle eine geeignete API oder herunterladbare Datei anbietet: Ein fertiger Datenfeed kann Ihnen ersparen, die Struktur der Quelle anhand einer Webseite nachzubauen.
Informationen zu LinkedIn-spezifischen Workflows für die Kontaktaufnahme finden Sie im Leitfaden zur Sales Navigator-Automatisierung von Linked Helper. Das ist ein anderer Anwendungsfall als das Erfassen beliebiger öffentlicher Webseiten.
Weiterführende Artikel:
Welches Web-Scraping-Tool sollten Sie wählen?
| Ihr Szenario | Meine Empfehlung | Entscheidungskriterium |
|---|---|---|
| Regelmäßig aktualisierte Tabelle | Browse AI | Orientieren Sie sich an der benötigten Ausgabe und dem Aufwand, den Ihr Team übernehmen möchte. Für eine regelmäßig aktualisierte Tabelle würde ich mit Browse AI beginnen. |
| Visuelle Desktop-Konfiguration und kostenpflichtige Cloud-Ausführung | Octoparse | Ziehen Sie Octoparse in Betracht, wenn diese Funktionen zu Ihrer Arbeitsweise passen. |
| Ein aktiv gepflegter Actor erledigt die konkrete Aufgabe bereits | Apify | Prüfen Sie den Beispieldatensatz und die Abrechnungsregeln, bevor Sie den Einstiegspreis der Plattform als Ihr Gesamtbudget betrachten. |
| Der HTML-Abruf ist der noch fehlende Baustein in einer Entwickler-Pipeline | ScrapingBee | Ich würde ScrapingBee wählen, wenn der HTML-Abruf der noch fehlende Baustein ist. |
| Die Inhaltskonvertierung steht im Mittelpunkt | Firecrawl | Ich würde Firecrawl wählen, wenn die Inhaltskonvertierung im Mittelpunkt steht. |
| Extraktionslogik, Datentypen und Wartung sollen in Python bleiben | Scrapy | Scrapy ist die Option, die ich wählen würde, wenn diese Aspekte unter der Kontrolle meines Teams bleiben sollen. |
Unabhängig von Ihrer Wahl sollten Sie zunächst eine kleine Stichprobe mit der Quelle vergleichen, bevor Sie eine größere zeitgesteuerte Ausführung einrichten. Der aussagekräftigste Test besteht darin, zu prüfen, ob die benötigten Felder korrekt erfasst werden – einschließlich fehlender Werte und der letzten Ergebnisseite.
Weitere berücksichtigte Tools
Playwright ist eine Überlegung wert, wenn Sie individuelle Browserinteraktionen programmieren müssen. Da es ein Framework zur Browserautomatisierung ist, müssen Sie die Funktionen für Extraktion und Speicherung selbst ergänzen.