 Actualizado: 26 de outubro de 2026
 24 minutos de leitura
Passar os dados de uma página para uma folha de cálculo parece uma tarefa simples. Depois, descobre que o preço está numa segunda página, que o plano gratuito não funciona enquanto o portátil está desligado e que «10 000 créditos» não significa 10 000 registos utilizáveis. Antes de comparar a extensão das listas de funcionalidades, escolheria uma ferramenta de web scraping com base nestes pormenores.
As minhas escolhas em resumo
Para tabelas recorrentes sem código, a minha escolha é o Browse AI; para programadores que pretendam obter HTML via API, é o ScrapingBee. O Apify é adequado para tarefas pré-configuradas na nuvem, o Firecrawl para conteúdos destinados a aplicações de AI, o Octoparse oferece fluxos de trabalho visuais no computador, com uma opção paga de execução na nuvem e o Scrapy dá aos programadores Python controlo sobre o rastreio e os resultados.
Como testei estas ferramentas e nota sobre a entidade que publica o artigo
Experimentei o «HTML Playground» do ScrapingBee e a pré-visualização pública do Firecrawl, abri o fluxo de trabalho gratuito com AI do Octoparse, processei um catálogo sintético com o Scrapy e comparei guias oficiais, preços e discussões públicas entre utilizadores. Estes pequenos testes abrangem a configuração e os resultados, não a fiabilidade em produção. A Linked Helper publica este blogue e disponibiliza uma ferramenta distinta para automatizar atividades no LinkedIn; essa ferramenta não faz parte desta seleção.
O que é uma ferramenta de web scraping?
Uma ferramenta de web scraping obtém páginas Web e extrai conteúdos para um formato utilizável, como HTML, Markdown, CSV ou JSON. Algumas ferramentas permitem selecionar campos visualmente; outras disponibilizam aos programadores uma API ou um framework. O rastreio descobre páginas, enquanto a extração transforma os respetivos conteúdos nos registos de que precisa.
Resumo das melhores ferramentas de web scraping
| Ferramenta | Mais indicada para | Funcionalidade de destaque | Preço inicial | Principal contrapartida |
|---|---|---|---|---|
| Browse AI | Tabelas recorrentes sem código | Robôs visuais e monitorização | 19 $/mês, com faturação anual; plano gratuito disponível | As linhas e as execuções consomem créditos |
| Apify | Tarefas pré-configuradas na nuvem | Mercado de Actors e conjuntos de dados | 19 $/mês, com faturação mensal; plano gratuito disponível | Os custos dos Actors variam |
| ScrapingBee | Obtenção de HTML via API | Opções de renderização e proxy | 19 $/mês, com faturação mensal | É necessário criar o fluxo de dados |
| Firecrawl | Conteúdos para aplicações de AI | Markdown e formatos estruturados | 19 $/mês, com faturação mensal; plano gratuito disponível | O JSON utiliza créditos adicionais |
| Octoparse | Fluxos de trabalho visuais com execução local e na nuvem | Extração local e agendamento pago na nuvem | 69 $/mês, com faturação anual; plano gratuito disponível | O agendamento clássico na nuvem exige um plano pago |
| Scrapy | Rastreios personalizados em Python | Seletores, fluxos de processamento e exportações de dados | 0 $ de licença de software | A manutenção do sistema fica a seu cargo |
O que distingue as melhores ferramentas de web scraping?
Uma ferramenta de web scraping útil fornece os campos certos no formato necessário para a etapa seguinte, por um custo que consegue prever. Começaria por uma página representativa, incluindo a parte mais complicada da tarefa: paginação, preços em falta ou um campo que só aparece depois de um clique.
O resultado de que realmente precisa. O HTML é útil quando está a escrever um analisador. O Markdown é útil quando uma aplicação de AI precisa do conteúdo da página num formato legível. Uma folha de cálculo precisa de colunas consistentes. Não pague por uma conversão de formato que irá desfazer de imediato.
Onde se encontram os dados. Vinte produtos numa página de listagem e vinte páginas de detalhe de produtos representam volumes de trabalho diferentes. Verifique se a ferramenta tem de abrir cada página de detalhe, renderizar JavaScript ou seguir outro conjunto de ligações.
Quem mantém tudo a funcionar. Uma ferramenta gratuita para computador pode ser suficiente para uma exportação mensal que executa sob supervisão. Uma tarefa diária precisa de um local de execução, um agendamento e uma forma de detetar resultados em falta. O alojamento na nuvem elimina algum trabalho, mas não elimina a necessidade de verificar os dados.
Um custo que consiga calcular. Procure o custo por pedido, linha, evento ou unidade de computação. Depois, verifique os custos adicionais associados às definições que irá utilizar. Um pedido básico barato pode transformar-se numa operação mais dispendiosa que recorra a um navegador ou a funcionalidades de AI.
Um resultado pequeno e fácil de inspecionar. Quero comparar alguns campos devolvidos com a fonte antes de agendar qualquer tarefa. Um código de sucesso HTTP indica que um pedido foi concluído; não indica que todos os produtos esperados foram obtidos.
As seis escolhas abrangem ferramentas visuais, APIs alojadas e código personalizado. Os contratos empresariais de fornecimento de dados e as ferramentas especializadas para plataformas sociais destinam-se a processos de aquisição mais específicos, pelo que não os tratei aqui como opções equivalentes.
1. Browse AI: a melhor opção para tabelas recorrentes sem código
Vantagens — Browse AI
-
Os robôs visuais podem ser usados em processos recorrentes de monitorização e extração.
-
O «Table Studio» propõe campos a partir de um URL sem exigir uma extensão do navegador.
Desvantagens — Browse AI
-
As execuções separadas em páginas de detalhe podem utilizar muito mais créditos do que uma única extração numa página de listagem.
-
O limite gratuito de 50 créditos é reduzido para uma monitorização diária.
O Browse AI é a minha escolha quando o objetivo final é uma tabela atualizada e não pretende manter seletores em código. O «Table Studio» começa com o URL de uma página e propõe colunas e linhas de exemplo. Analisa os campos, escolhe quantos elementos pretende extrair e guarda o robô para execuções repetidas.
Gosto desta separação entre criar uma tabela e agendar a sua execução. Se estiver a acompanhar o catálogo de um fornecedor, pode pensar nas colunas de que precisa em vez de pensar no pedido que obtém cada página. No entanto, o «Table Studio» ainda está em versão beta e os percursos interativos devem ser criados no «Robot Studio»: percorrer um formulário com vários cliques é uma tarefa diferente de ler uma lista que já está visível.
O que constatei — Browse AI
Contaria as visitas às páginas antes de contar as linhas. Segundo as regras padrão de créditos, 20 elementos numa única página de listagem custam dois créditos. Executar um robô separadamente em 20 páginas de detalhe custa pelo menos 20 créditos, antes de qualquer execução utilizada para descobrir essas ligações. O custo é dez vezes superior para o mesmo número de elementos.
O problema é a rapidez com que as execuções repetidas consomem o limite gratuito. Uma extração diária de uma lista com 20 linhas utiliza 60 créditos num mês de 30 dias, ultrapassando por pouco os 50 do plano Free. Não escolheria esta opção se a sua equipa já pretendesse escrever o próprio analisador e controlar todos os pedidos; estaria a pagar por um fluxo de trabalho visual de que talvez não precisasse.
Preços do Browse AI
A partir de 19 $/mês, com faturação anual, para o plano Personal; plano gratuito disponível.
-
Free — 50 créditos/mês em dois sites.
-
Personal — 19 $/mês, com faturação anual e 12 000 créditos disponibilizados antecipadamente todos os anos.
-
Professional — 69 $/mês, com faturação anual, 60 000 créditos anuais e dez sites.
2. Apify: a melhor opção para tarefas pré-configuradas de web scraping na nuvem
Vantagens — Apify
-
Os Actors específicos para determinados sites podem evitar que tenha de criar um extrator de raiz.
-
Os conjuntos de dados suportam formatos que incluem CSV, JSON e Excel.
Desvantagens — Apify
-
Cada Actor tem os próprios requisitos de entrada e modelo de cobrança.
-
O crédito da plataforma não corresponde a um número fixo de linhas.
Vale a pena considerar o Apify quando já existe um Actor pré-configurado para o site ou fluxo de trabalho pretendido. Um Actor é um programa que pode executar na nuvem do Apify; pode ser uma ferramenta especializada de web scraping ou uma ferramenta mais geral que exige configuração adicional. A questão importante é saber se esse Actor específico devolve os campos de que precisa.
Gosto de ter a execução e o acesso ao conjunto de dados na mesma plataforma. Pode começar com um Actor adequado, inspecionar um exemplo dos respetivos resultados e preparar outra aplicação para utilizar o conjunto de dados. É um ponto de partida mais útil do que comprar infraestrutura antes de encontrar um extrator que funcione.
Ainda assim, a escolha do Actor exige atenção. Numa discussão de setembro de 2026 em r/scrapingtheweb, u/Heiswasistocome escreveu: “I am looking at Apify and feeling overwhelmed at the number of actors who can do what I want them to do.” Limitaria a pesquisa com base nos campos devolvidos, na manutenção recente e num pequeno teste, e não apenas na popularidade.
O problema são os dois níveis de preços. Os Actors podem cobrar por eventos ou utilização, com os custos da plataforma incluídos ou separados, consoante o Actor. A unidade de computação do Apify mede a utilização de um gigabyte de RAM durante uma hora; não indica quantos produtos irá obter. Não escolheria o Apify se pretendesse um único preço universal por página para ferramentas de web scraping distintas.
Vale a pena verificar um pormenor da exportação antes de conceber uma folha de cálculo para a etapa seguinte: ao selecionar campos, só pode indicar nomes de nível superior; ao indicar campos a omitir, pode usar caminhos aninhados. Um resultado aninhado poderá ter de ser reestruturado antes de se transformar na tabela plana que imaginou.
Preços do Apify
A partir de 19 $/mês para o plano Starter, com faturação mensal, mais a utilização que exceda o montante incluído; plano gratuito disponível.
-
Free — 5 $ de utilização da plataforma por mês.
-
Starter — o valor da subscrição fica disponível como crédito de utilização.
-
Custos dos Actors — verifique separadamente os eventos, a utilização e os custos da plataforma incluídos no Actor selecionado.
3. ScrapingBee: a melhor opção para obter HTML via API
Vantagens — ScrapingBee
-
Os pedidos de HTML simples podem custar um crédito cada.
-
As opções de renderização, proxy e extração estão disponíveis numa única API.
Desvantagens — ScrapingBee
-
As definições alteram o custo em créditos de cada pedido.
-
O agendamento, o armazenamento e a validação posterior ficam a seu cargo.
O ScrapingBee é a minha escolha para programadores que pretendam delegar a obtenção das páginas sem comprar uma plataforma visual completa de dados. Envia um URL e uma configuração e trabalha depois com a resposta na própria aplicação. Esta abordagem adequa-se a um fluxo existente no qual já sabe como os resultados devem ser analisados, armazenados e verificados.
Experimentei o respetivo «HTML Playground» numa página do ambiente de testes Books to Scrape. Com o modo «Auto» e a renderização de JavaScript desativados, o pedido devolveu HTTP 200 e a interface indicou o consumo de um crédito. Foi uma verificação útil da configuração; uma página de demonstração simples revela pouco sobre sites difíceis.
O que constatei — ScrapingBee
É importante verificar as opções antes de premir o botão. O «Playground» começou com o modo «Auto» ativado. Quando o desativei, a renderização de JavaScript estava selecionada separadamente; ao desativá-la, obtive a configuração pretendida, que consumia apenas um crédito. Por predefinição, a API renderiza JavaScript, o que custa cinco créditos; um pedido simples sem renderização custa apenas um.
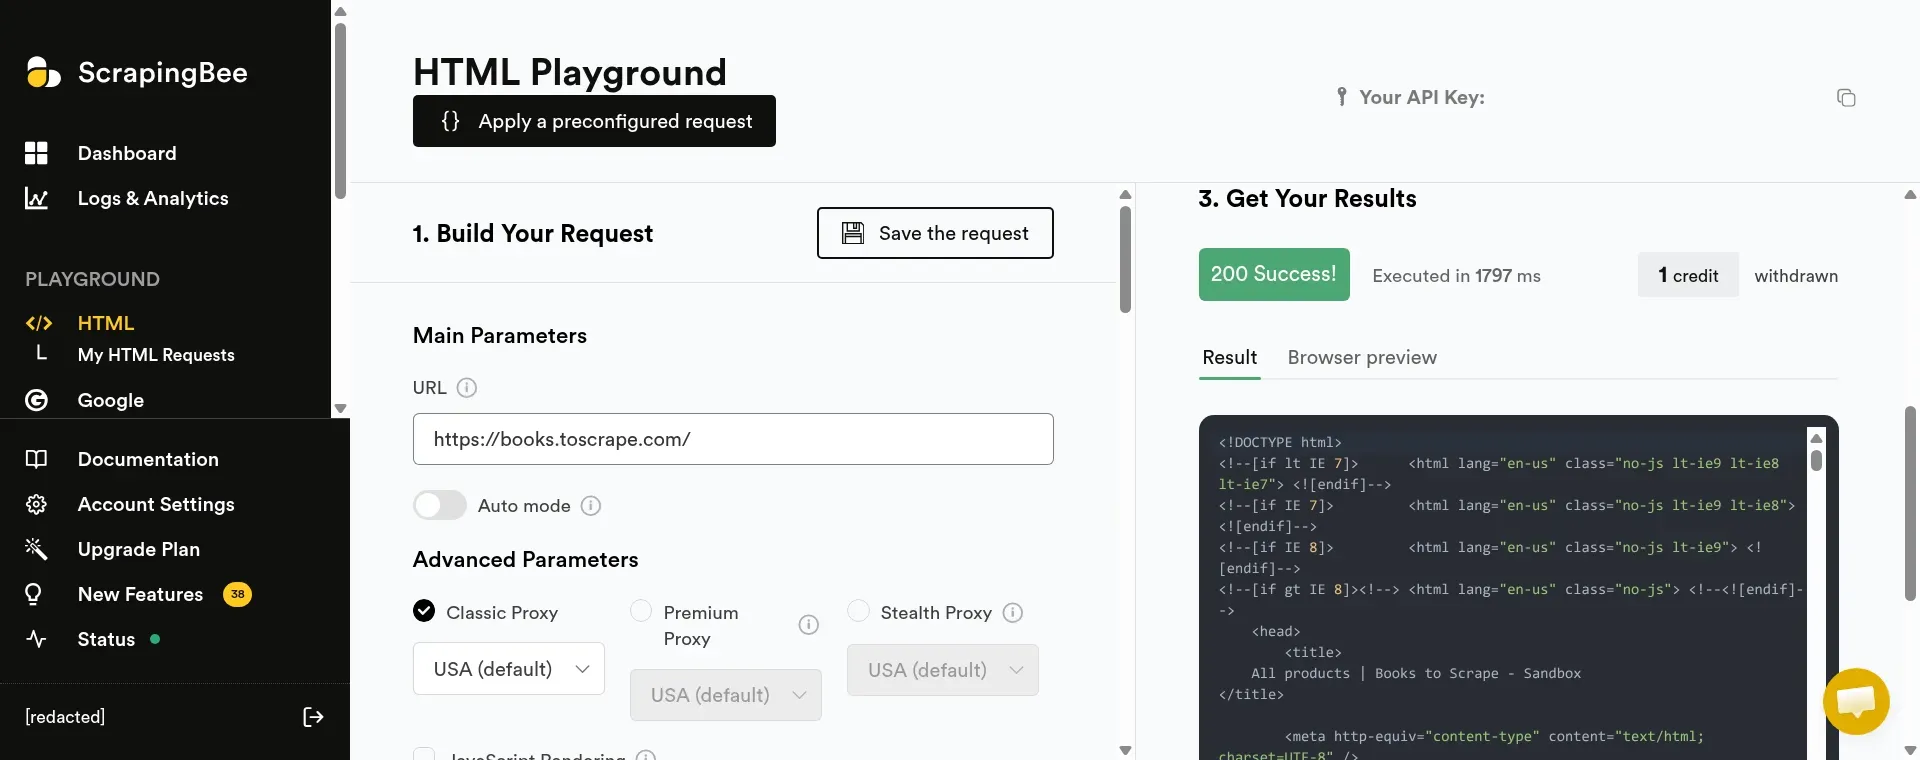
No «HTML Playground» do ScrapingBee, o pedido da página simples devolveu um resultado e indicou o consumo de um crédito.
Gosto deste controlo quando as páginas não precisam de um navegador, pois permite evitar pagar por uma renderização desnecessária. O problema é que continuará a ter de transformar a página obtida em registos fiáveis. Não escolheria esta opção se pretendesse uma folha de cálculo de monitorização pronta a utilizar sem criar um fluxo de trabalho em torno da API.
Preços do ScrapingBee
A partir de 19 $/mês, com faturação mensal, para o plano Hobby; está disponível um período experimental com 1 000 créditos.
-
Hobby — 19 $/mês por 75 000 créditos e 25 pedidos simultâneos.
-
Freelance — 49 $/mês por 250 000 créditos e 50 pedidos simultâneos.
-
Definições dos pedidos — o HTML padrão custa um crédito; a renderização de JavaScript custa cinco; as opções premium custam mais.
4. Firecrawl: a melhor opção para conteúdos destinados a aplicações de AI
Vantagens — Firecrawl
-
Devolve Markdown, HTML e formatos de extração estruturados.
-
Um «Playground» público permite experimentar uma página e inspecionar uma pré-visualização.
Desvantagens — Firecrawl
-
A extração de JSON estruturado acrescenta créditos ao custo base da página.
-
Uma pré-visualização bem-sucedida não substitui a verificação do resultado completo.
O Firecrawl é a minha escolha quando a etapa seguinte precisa de conteúdos legíveis da página, em vez de HTML em bruto. O Markdown é adequado para processos de recuperação de informação e aplicações de AI; o JSON estruturado é adequado quando a etapa seguinte exige campos com nomes definidos. Gosto de ter estas opções num único local, mas decidiria qual o resultado necessário antes de calcular o custo.
Enviei a página do ambiente de testes Books to Scrape para o «Playground» público, a página foi processada com êxito e recebi uma pré-visualização em Markdown. Manteve a ligação «Home» e o título «All products». O resultado completo exigia uma conta, pelo que a minha verificação terminou nessa pré-visualização, em vez de incluir uma exportação verificada de todos os produtos.
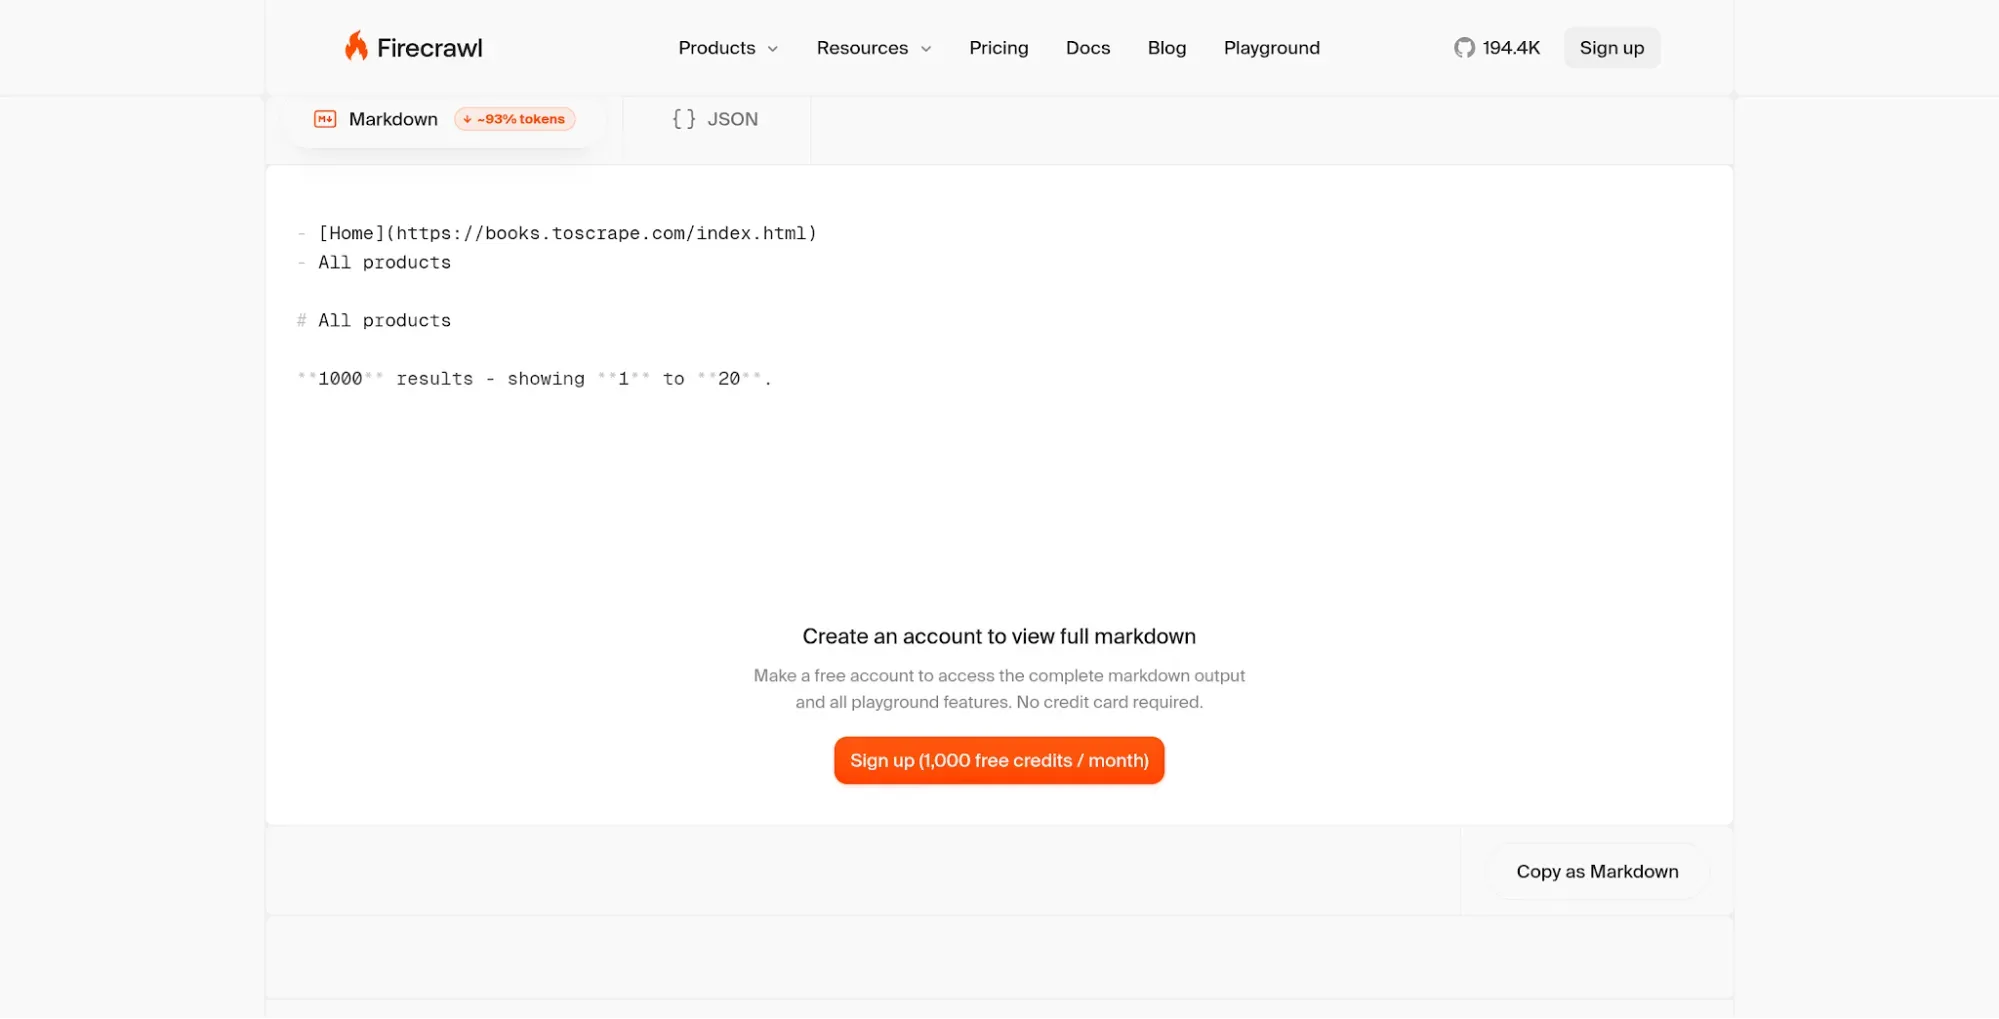
No «Playground» público do Firecrawl, a pré-visualização em Markdown mantém a navegação e um título da página; o resultado completo exige uma conta.
Este pequeno pormenor é importante: conteúdo legível em Markdown não se transforma automaticamente numa tabela com campos de produtos organizados. Se estiver a transferir um catálogo para uma base de dados, continuará a precisar de um esquema e de verificações de valores em falta. Se estiver a fornecer o conteúdo de uma página a uma aplicação de AI, uma representação textual mais ampla poderá ser exatamente aquilo de que precisa.
A principal desvantagem é que o formato de saída escolhido pode multiplicar o consumo de créditos. Uma extração básica custa um crédito por página; acrescentar a extração de JSON aumenta o custo para cinco. Numa publicação de setembro de 2026 em r/automation, u/Rankspartanben elogiou o apoio do Firecrawl, mas descreveu a ferramenta como “quite expensive”. Encararia esse comentário como um incentivo para calcular o preço do formato e do volume necessários, e não como um motivo para rejeitar a ferramenta.
Não escolheria o Firecrawl se apenas precisasse de uma extração visual ocasional para CSV. As funcionalidades de conversão e de API fazem mais sentido quando está a criar um fluxo recorrente de processamento de conteúdos.
Preços do Firecrawl
A partir de 19 $/mês, com faturação mensal, para o plano Hobby; plano gratuito disponível.
-
Free — 1 000 créditos renovados mensalmente.
-
Hobby — 19 $/mês por 5 000 créditos mensais; os créditos adicionais custam 5 $ por cada 1 000.
-
Standard — 99 $/mês por 100 000 créditos mensais.
5. Octoparse: a melhor opção para fluxos de trabalho visuais com execução local e na nuvem
Vantagens — Octoparse
-
A extração local gratuita permite começar sem uma subscrição.
-
O plano Standard acrescenta extração na nuvem, agendamento e uma API de exportação de dados.
Desvantagens — Octoparse
-
O agendamento clássico na nuvem exige um plano pago; os limites da versão beta com AI são diferentes.
-
Os serviços opcionais de proxy e configuração podem aumentar o preço do plano.
Vale a pena considerar o Octoparse quando pretende criar visualmente fluxos de trabalho de extração e manter a opção de os executar na nuvem. Pode começar com modelos, com o «AI Assistant» ou com a aplicação para computador. Os planos clássicos pagos acrescentam capacidade e agendamento na nuvem para tarefas cuja execução não quer que dependa do seu computador.
Gosto da distinção entre o trabalho local e na nuvem porque oferece uma forma prática de avaliar se vale a pena subscrever um plano. Se estiver a exportar um catálogo uma vez por mês enquanto está à secretária, a opção de execução local gratuita poderá ser suficiente. Se esse mesmo catálogo tiver de ser atualizado todas as manhãs, o agendamento do plano Standard é a funcionalidade que está efetivamente a comprar.
Na opção clássica para computador, o plano Free inclui dez tarefas, um dispositivo e 50 000 linhas de exportação por mês, com um máximo de 10 000 linhas por exportação. O plano Standard aumenta o limite para 100 tarefas e inclui até três processos simultâneos na nuvem. Estes números medem aspetos diferentes: uma tarefa é um fluxo de trabalho guardado, enquanto as linhas exportadas são os dados que este produz.
O que constatei — Octoparse
A consola gratuita ofereceu mais opções do que eu esperava encontrar na aplicação para computador. O respetivo «AI Assistant» permitiu-me escolher uma versão beta do «Cloud Agent», que gera e executa um scraper personalizado. Experimentei essa opção sem comprar um plano. Manteria esta opção separada da comparação do agendamento clássico: não verifiquei a existência de um limite recorrente para a versão beta.
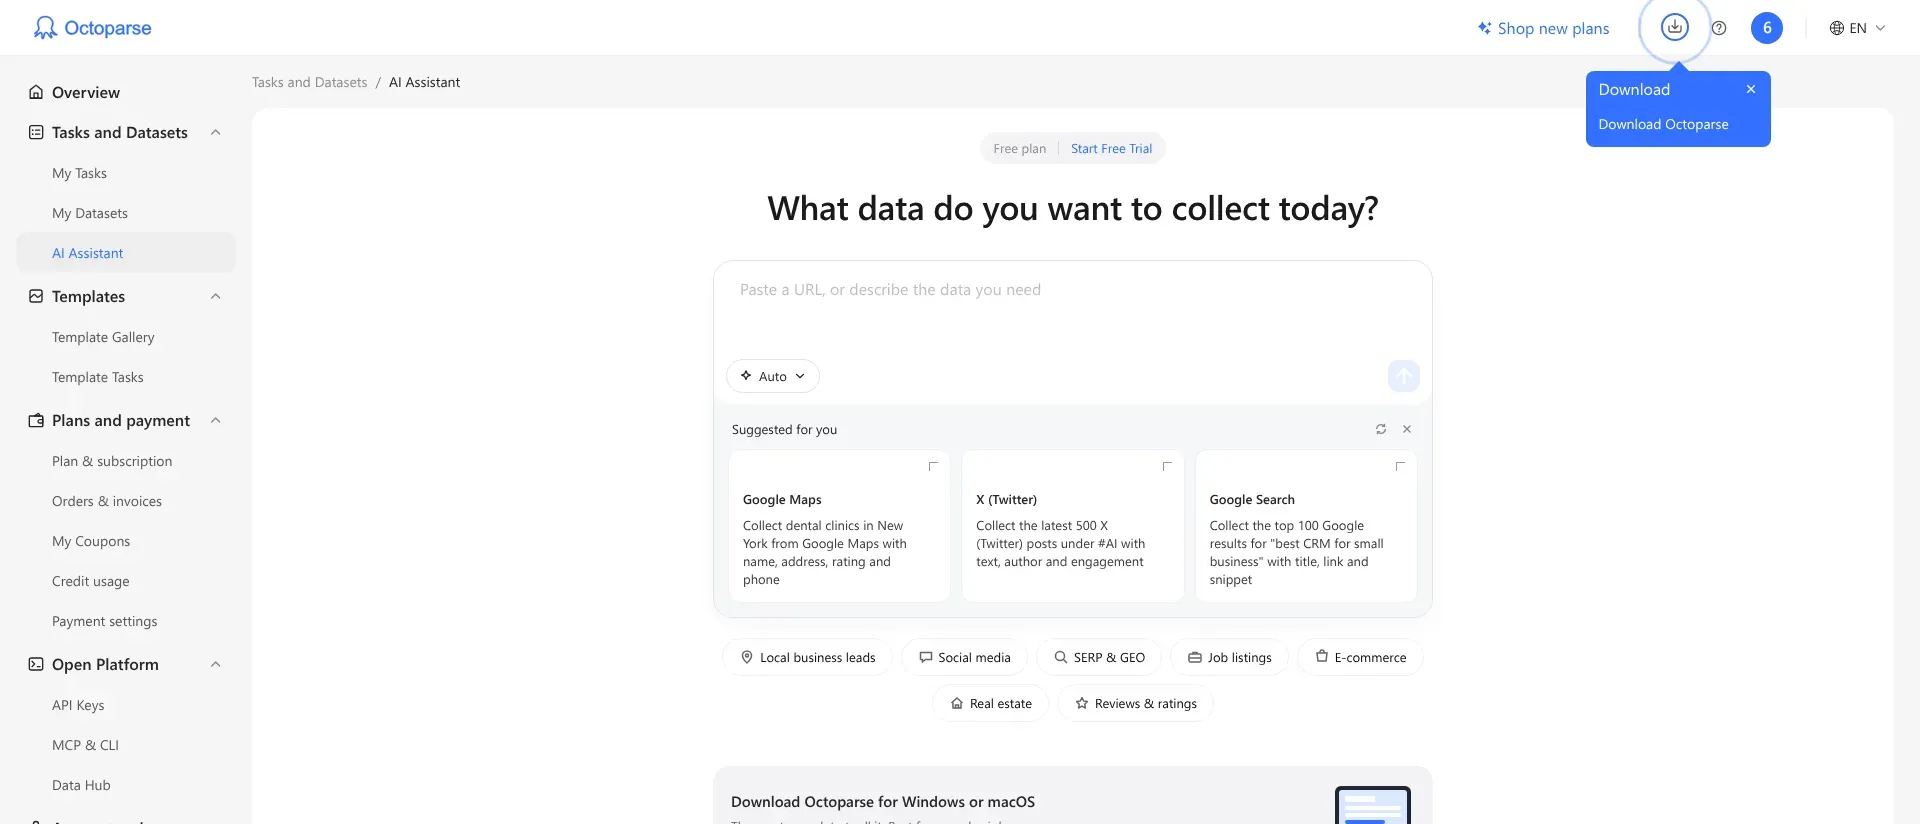
No plano «Free» do Octoparse, o «AI Assistant» oferece um ponto de partida baseado nas instruções do utilizador, juntamente com a opção para computador.
O problema é que uma ferramenta sem código não elimina a necessidade de manter o fluxo de trabalho. Quando uma página muda, alguém continua a ter de verificar os campos selecionados e os dados devolvidos. Não escolheria esta opção se preferisse uma integração centrada numa API e já tivesse um analisador; o ScrapingBee é uma solução mais direta para essa tarefa.
Preços do Octoparse
A partir de 69 $/mês, com faturação anual, para o plano Standard; plano gratuito disponível.
-
Free — extração local, dez tarefas e 50 000 linhas de exportação mensais.
-
Standard — 69 $/mês, com faturação anual, extração na nuvem e agendamento.
-
Professional — 249 $/mês, com faturação anual e 20 processos simultâneos na nuvem.
6. Scrapy: a melhor opção para rastreios personalizados em Python
Vantagens — Scrapy
-
Sem custos de licença de software e com controlo sobre os seletores e o processamento.
-
As exportações de dados integradas incluem CSV e JSON.
Desvantagens — Scrapy
-
O código, o ambiente de execução e a manutenção ficam a seu cargo.
-
A renderização no navegador exige uma integração separada quando a página assim o requer.
O Scrapy é a minha escolha quando a lógica de extração deve ser integrada na base de código da sua equipa. Escreve um spider para selecionar os campos e seguir as ligações de que precisa e utiliza depois fluxos de processamento e exportações de dados para tratar e exportar os resultados. Assim, dispõe de margem para tratar explicitamente as exceções, em vez de tentar adaptar todos os sites a um modelo visual.
Executei o Scrapy 2.19.0 num catálogo local sintético com três produtos. O spider exportou ficheiros CSV e JSON, e o produto sem existências manteve o valor zero. Também defini a seguinte ordem para os campos do CSV: title, price e stock. Esta verificação não exigiu uma conta nem um serviço pago.
O que constatei — Scrapy
Mesmo uma exportação bem-sucedida deixa as decisões sobre os tipos de dados a seu cargo. Os meus seletores devolveram os preços e as existências como cadeias de texto: «12.50» e «0» foram preservados, mas o spider não os converteu automaticamente em campos numéricos. Valorizo esse controlo explícito num fluxo de trabalho cuja manutenção fica a cargo da equipa. Precisará de regras de conversão e validação antes de efetuar cálculos nas etapas seguintes.
A desvantagem está em toda a infraestrutura necessária para executar e manter o spider. Fica responsável pelo alojamento, pelo agendamento, pela política de repetição de pedidos adequada ao site e pelos alertas quando o resultado muda. O Scrapy também não renderiza por si só páginas arbitrárias com JavaScript; poderá precisar de outra fonte de dados ou de uma integração com um navegador.
Não escolheria o Scrapy se ninguém na sua equipa quisesse manter código Python. O software gratuito pode ser um bom negócio, mas não elimina o tempo de desenvolvimento.
Preços do Scrapy
0 $ de licença de software; a execução e a manutenção têm custos separados.
-
Framework — código aberto, sem custos de software por página.
-
Operações — reserve orçamento para o alojamento, a monitorização e o trabalho de desenvolvimento a seu cargo.
Quanto custa o mesmo volume de trabalho
A opção mais barata depende do resultado pretendido e de quem executa o trabalho. Estes valores baseiam-se em cálculos feitos a partir dos planos verificados, e não em testes de grande escala. Os preços são apresentados em USD antes de impostos e não incluem sites premium, proxies pagos nem serviços opcionais de configuração. O tempo de desenvolvimento está excluído.
Cenário 1: uma verificação diária e agendada de um catálogo com uma ferramenta visual
Considere uma página pública padrão, suportada pela ferramenta, com 20 linhas, obtida uma vez por dia durante 30 dias em cada mês. São 600 linhas e 30 execuções mensais. A comparação exige execuções sem supervisão na nuvem e uma tabela configurada. As execuções locais do plano clássico Free do Octoparse não cumprem esse requisito; os limites recorrentes da versão beta com AI não foram verificados, pelo que esta não foi contabilizada como um serviço agendado equivalente.
| Ferramenta | Plano adequado | Subscrição anual | Custos adicionais obrigatórios neste cenário | Limite a acompanhar |
|---|---|---|---|---|
| Browse AI | Personal, faturação anual | 228 $ pagos antecipadamente | Nenhum segundo os pressupostos indicados | 60 créditos/mês; 720/ano de um total de 12 000 |
| Octoparse | Standard, faturação anual | 828 $ pagos antecipadamente | Nenhum segundo os pressupostos indicados | Uma de 100 tarefas; três processos na nuvem |
Começaria pelo Browse AI para esta pequena tabela atualizada regularmente, caso a página permitisse configurar o robô sem dificuldades. O preço mais elevado do Octoparse faz mais sentido se também precisar dos seus fluxos de trabalho visuais mais abrangentes, com execução local e na nuvem. Antes de escolher qualquer uma das opções, confirme se os campos necessários se encontram nessa única página: as visitas às páginas de detalhe alteram a tarefa.
Cenário 2: 10 000 pedidos de páginas HTML simples por mês
Considere 10 000 pedidos bem-sucedidos de páginas, com saída em HTML em bruto, sem renderização de JavaScript, proxies premium nem extração de campos com AI. A sua aplicação assegura o agendamento, a análise e o armazenamento. Os totais utilizam doze pagamentos mensais, pelo que a comparação não inclui qualquer desconto por pré-pagamento anual.
| Ferramenta | Plano adequado | Custo durante 12 meses | Custos adicionais obrigatórios incluídos | Limite a acompanhar |
|---|---|---|---|---|
| ScrapingBee | Hobby, faturação mensal | 228 $ | Nenhum; 10 000 créditos estão abrangidos pelo plano | 75 000 créditos/mês; desativar JS |
| Firecrawl | Hobby com pagamento consoante a utilização | 528 $ | 25 $/mês por 5 000 créditos adicionais | Ativar «PAYG» (pagamento consoante a utilização) com um limite mensal suficiente |
Neste caso, o ScrapingBee utiliza 10 000 créditos mensais. O Firecrawl chega aos 44 $ por mês depois de incluir os créditos adicionais; não é necessário mudar para o plano Standard para este volume de trabalho.
Com estes pressupostos, escolheria o ScrapingBee. Se o resultado mudar para JSON extraído por AI, volte a fazer os cálculos: o Firecrawl utiliza cinco créditos por página e a extração com AI do ScrapingBee acrescenta cinco créditos ao pedido subjacente. A comparação anterior, baseada na obtenção de HTML simples a baixo custo, deixa de responder à sua questão.
O Apify e o Scrapy exigem estimativas diferentes. As regras de cobrança e o tempo de execução de um Actor do Apify determinam o respetivo total; a licença do Scrapy é gratuita, mas o alojamento e o trabalho não são. Não atribuiria uma estimativa anual sem fundamento a nenhuma das opções sem uma execução representativa e um plano de execução.
Verifique primeiro as tecnologias que já utiliza
Uma função da folha de cálculo ou uma exportação fornecida pela fonte pode resolver uma pequena tarefa antes de acrescentar outra subscrição. A função IMPORTHTML do Google Sheets pode importar uma tabela ou lista HTML indicando o respetivo índice. O conector «From Web» do Power Query do Excel permite selecionar as tabelas detetadas e transformar os resultados.
Experimentaria estas opções para uma tabela ocasional e simples. Quando o fluxo de trabalho passa a exigir interações no navegador, vários modelos de páginas ou execuções fiáveis sem supervisão, uma ferramenta dedicada de web scraping torna-se mais útil. Verifique também se a fonte disponibiliza uma API adequada ou um ficheiro que possa descarregar: um fluxo de dados pronto a utilizar pode evitar que tenha de reconstruir a estrutura a partir de uma página.
Para fluxos de trabalho de prospeção específicos do LinkedIn, consulte o guia de automatização do Sales Navigator da Linked Helper. Trata-se de um caso de utilização distinto da recolha de dados em páginas Web públicas em geral.
Leitura relacionada:
- As melhores ferramentas de scraping do LinkedIn em 2026 (gratuitas e pagas)
- Exportar leads do LinkedIn para CSV
Que ferramenta de web scraping deve escolher?
| O seu cenário | A minha escolha | O fator decisivo |
|---|---|---|
| Tabela atualizada regularmente | Browse AI | Escolha com base no resultado de que precisa e no trabalho que a sua equipa está disposta a assumir. Começaria pelo Browse AI para uma tabela atualizada regularmente. |
| Configuração visual no computador e execução paga na nuvem | Octoparse | Considere o Octoparse se estas características se adequarem à sua forma de trabalhar. |
| Um Actor com manutenção ativa já executa a tarefa específica | Apify | Verifique o conjunto de dados de exemplo e as regras de cobrança antes de concluir que o preço inicial da plataforma corresponde ao orçamento total. |
| A obtenção de HTML é a peça em falta num fluxo para programadores | ScrapingBee | Escolheria o ScrapingBee se a obtenção de HTML fosse a peça em falta. |
| A conversão de conteúdos é fundamental | Firecrawl | Escolheria o Firecrawl se a conversão de conteúdos fosse fundamental. |
| A lógica de extração, os tipos de dados e a manutenção devem continuar a ser geridos em Python | Scrapy | Escolheria o Scrapy se a lógica de extração, os tipos de dados e a manutenção devessem permanecer sob o controlo da minha equipa. |
Independentemente da opção escolhida, compare um pequeno resultado com a fonte antes de agendar uma execução maior. O teste mais útil consiste em verificar se os campos necessários são devolvidos corretamente, incluindo os valores em falta e a última página de resultados.
Outras ferramentas que considerei
Vale a pena considerar o Playwright quando precisa de programar interações personalizadas no navegador. Trata-se de um framework de automatização de navegadores, pelo que terá ainda de implementar separadamente a extração e o armazenamento.