 Mise à Jour: 26 octobre 2026
 24 minutes de lecture
Importer une page dans une feuille de calcul semble être une tâche simple. Puis vous découvrez que le prix se trouve sur une deuxième page, que la formule gratuite ne fonctionne pas lorsque votre ordinateur est éteint et que « 10 000 crédits » ne signifie pas 10 000 enregistrements exploitables. Je choisirais un outil de scraping en fonction de ces détails avant de comparer la richesse de ses fonctionnalités.
Mes choix en un coup d’œil
Pour les tableaux actualisés régulièrement sans code, mon choix est Browse AI ; pour un développeur qui souhaite obtenir du HTML via une API, c’est ScrapingBee. Apify convient aux tâches prêtes à l’emploi exécutées dans le cloud, Firecrawl au contenu destiné aux applications d’AI, Octoparse propose des processus visuels dans son application de bureau avec une option payante dans le cloud, tandis que Scrapy permet aux développeurs Python de contrôler l’exploration web et les résultats.
Méthode d’évaluation de ces outils et déclaration de l’éditeur
J’ai essayé le « HTML Playground » de ScrapingBee et le « Playground » public de Firecrawl, ouvert le processus gratuit d’Octoparse fondé sur l’AI, testé Scrapy sur un catalogue synthétique et comparé les guides officiels, les tarifs et les discussions publiques d’utilisateurs. Ces vérifications à petite échelle portent sur la configuration et les résultats, pas sur la fiabilité en production. Linked Helper publie ce blog et propose séparément un outil d’automatisation de la prospection sur LinkedIn ; il ne figure pas parmi les outils retenus.
Qu’est-ce qu’un outil de web scraping ?
Un outil de web scraping récupère des pages web et en extrait le contenu dans un format exploitable, comme HTML, Markdown, CSV ou JSON. Certains outils vous permettent de sélectionner visuellement les champs ; d’autres proposent aux développeurs une API ou un cadre de développement. L’exploration web permet de découvrir les pages, tandis que l’extraction transforme leur contenu en données exploitables.
Les meilleurs outils de web scraping en un coup d’œil
| Outil | Idéal pour | Fonctionnalité phare | Prix de départ | Principal compromis |
|---|---|---|---|---|
| Browse AI | Tableaux actualisés régulièrement sans code | Robots visuels et suivi | 19 $/mois, facturés annuellement ; formule gratuite disponible | Les lignes et les exécutions consomment des crédits |
| Apify | Tâches prêtes à l’emploi exécutées dans le cloud | Place de marché d’Actors et jeux de données | 19 $/mois, facturés mensuellement ; formule gratuite disponible | Les frais varient selon l’Actor |
| ScrapingBee | HTML via une API | Options de rendu et de proxy | 19 $/mois, facturés mensuellement | Vous devez créer la chaîne de traitement des données |
| Firecrawl | Contenu destiné aux applications d’AI | Markdown et formats structurés | 19 $/mois, facturés mensuellement ; formule gratuite disponible | JSON consomme des crédits supplémentaires |
| Octoparse | Processus visuels, de l’application de bureau au cloud | Extraction locale et planification payante dans le cloud | 69 $/mois, facturés annuellement ; formule gratuite disponible | La planification classique dans le cloud nécessite une formule payante |
| Scrapy | Explorations web personnalisées en Python | Sélecteurs, chaînes de traitement et exportations de flux | Licence logicielle gratuite | Vous assurez la maintenance du système |
Quelles qualités distinguent les meilleurs outils de web scraping ?
Un outil de scraping efficace produit les champs nécessaires dans un format exploitable à l’étape suivante, pour un coût prévisible. Je commencerais par une page représentative, en incluant la partie délicate de la tâche : pagination, prix manquants ou champ qui n’apparaît qu’après un clic.
Le résultat dont vous avez réellement besoin. HTML est utile lorsque vous écrivez un parseur. Markdown est utile lorsqu’une application d’AI a besoin d’un contenu de page lisible. Une feuille de calcul exige des colonnes stables. Ne payez pas pour une conversion de format que vous annulerez immédiatement.
L’emplacement des données. Vingt produits sur une même page de liste et vingt fiches produit distinctes représentent des charges de travail différentes. Vérifiez si l’outil doit ouvrir chaque page de détail, effectuer le rendu JavaScript ou suivre une autre série de liens.
Qui assure l’exécution dans la durée ? Un outil gratuit installé sur un ordinateur peut suffire à une exportation mensuelle que vous supervisez. Une tâche quotidienne nécessite un environnement d’exécution, une planification et un moyen de détecter les résultats manquants. L’hébergement dans le cloud supprime une partie du travail ; il ne vous dispense pas de vérifier vos données.
Un coût que vous pouvez calculer à l’avance. Recherchez le tarif par requête, ligne, événement ou unité de calcul. Vérifiez ensuite les suppléments associés aux paramètres que vous utiliserez. Une requête de base peu coûteuse peut devenir une opération plus onéreuse si elle mobilise un navigateur ou l’AI.
Un petit échantillon facile à vérifier. Je veux comparer quelques champs renvoyés avec la source avant de planifier quoi que ce soit. Un code HTTP indiquant un succès vous confirme qu’une requête a abouti ; il ne garantit pas que tous les produits attendus ont été récupérés.
Les six outils retenus comprennent des solutions visuelles, des API hébergées et du code personnalisé. Les contrats d’entreprise portant sur la livraison de données et les outils spécialisés pour les plateformes sociales répondent à des besoins d’achat plus spécialisés ; je ne les ai donc pas traités ici comme des options interchangeables.
1. Browse AI : le meilleur choix pour les tableaux actualisés régulièrement sans code
Avantages — Browse AI
-
Les robots visuels permettent d’automatiser le suivi et les extractions récurrentes.
-
« Table Studio » propose des champs à partir d’une URL sans nécessiter d’extension de navigateur.
Inconvénients — Browse AI
-
Des exécutions distinctes sur les pages de détail peuvent consommer beaucoup plus de crédits qu’une seule extraction de page de liste.
-
Le quota de 50 crédits de la formule « Free » est limité pour un suivi quotidien.
Browse AI est mon choix lorsque votre objectif final est d’obtenir un tableau actualisé sans avoir à maintenir des sélecteurs dans le code. L’outil « Table Studio » part de l’URL d’une page et propose des colonnes ainsi que des exemples de lignes. Vous vérifiez les champs, choisissez le nombre d’éléments à récupérer, puis enregistrez le robot afin de le réutiliser lors des exécutions suivantes.
J’apprécie cette séparation entre la création d’un tableau et sa planification. Si vous surveillez le catalogue d’un fournisseur, vous pouvez raisonner en fonction des colonnes dont vous avez besoin plutôt que de la requête qui récupère chaque page. « Table Studio » est toutefois encore en version bêta, et les parcours interactifs relèvent de « Robot Studio » : remplir un formulaire en plusieurs étapes est une tâche différente de la lecture d’une liste déjà visible.
Ce que j’ai constaté — Browse AI
Je compterais les visites de pages avant de compter les lignes. Selon les règles standard relatives aux crédits, 20 éléments sur une seule page de liste coûtent deux crédits. L’exécution distincte d’un robot sur 20 pages de détail coûte au moins 20 crédits, sans compter l’exécution éventuellement nécessaire pour trouver ces liens. Pour le même nombre d’éléments, le coût est donc multiplié par dix.
Le problème réside dans la vitesse à laquelle les exécutions répétées épuisent le quota gratuit. L’extraction quotidienne d’une liste de 20 lignes consomme 60 crédits sur un mois de 30 jours, soit un peu plus que les 50 crédits de la formule « Free ». J’éviterais cet outil si votre équipe souhaite déjà écrire son propre parseur et contrôler chaque requête ; vous paieriez pour un processus visuel dont vous n’avez peut-être pas besoin.
Tarifs de Browse AI
À partir de 19 $/mois, facturés annuellement, pour la formule « Personal » ; formule « Free » disponible.
-
« Free » — 50 crédits/mois pour deux sites web.
-
« Personal » — 19 $/mois, facturés annuellement, avec 12 000 crédits fournis à l’avance chaque année.
-
« Professional » — 69 $/mois, facturés annuellement, avec 60 000 crédits annuels et dix sites web.
2. Apify : le meilleur choix pour les tâches de scraping prêtes à l’emploi dans le cloud
Avantages — Apify
-
Les Actors conçus pour des sites web précis peuvent vous éviter de créer un extracteur de toutes pièces.
-
Les jeux de données prennent en charge des formats comme CSV, JSON et Excel.
Inconvénients — Apify
-
Chaque Actor possède ses propres paramètres et données d’entrée requis, ainsi que son propre modèle tarifaire.
-
Le crédit de la plateforme ne correspond pas à un nombre fixe de lignes.
Apify mérite votre attention lorsqu’un Actor prêt à l’emploi couvre déjà le site ou le processus que vous ciblez. Un Actor est un programme que vous pouvez exécuter dans le cloud d’Apify ; il peut s’agir d’un outil de scraping spécialisé ou d’un outil plus général nécessitant une configuration supplémentaire. La question essentielle est de savoir si cet Actor précis renvoie les champs dont vous avez besoin.
J’apprécie de disposer de l’exécution et de l’accès aux jeux de données sur une même plateforme. Vous pouvez commencer par un Actor adapté, examiner un exemple de résultat et permettre à une autre application d’exploiter le jeu de données. C’est un point de départ plus utile que l’achat d’une infrastructure avant même d’avoir trouvé un extracteur fonctionnel.
Le choix de l’Actor demande néanmoins de l’attention. Dans une discussion publiée en septembre 2026 sur r/scrapingtheweb, u/Heiswasistocome écrivait : “I am looking at Apify and feeling overwhelmed at the number of actors who can do what I want them to do.” Je filtrerais les options selon les champs renvoyés, la date de la dernière mise à jour et les résultats d’un essai à petite échelle, plutôt que de me fier uniquement à leur popularité.
Le problème tient à une tarification à deux niveaux. Les Actors peuvent facturer les événements ou l’utilisation, les coûts de la plateforme étant inclus ou séparés selon l’Actor. L’unité de calcul d’Apify mesure l’utilisation d’un gigaoctet de RAM pendant une heure ; elle ne vous indique pas combien de produits vous obtiendrez. J’éviterais Apify si vous recherchez un tarif universel par page pour des outils de scraping très différents.
Un détail relatif à l’exportation mérite d’être vérifié avant de concevoir une feuille de calcul destinée à exploiter les données : la sélection des champs d’un jeu de données accepte les noms de premier niveau ; pour exclure des champs, vous pouvez en revanche indiquer des chemins imbriqués. Un résultat imbriqué peut nécessiter une restructuration avant de devenir le tableau à plat que vous aviez en tête.
Tarifs d’Apify
À partir de 19 $/mois, facturés mensuellement, pour la formule « Starter », auxquels s’ajoute l’utilisation dépassant le montant inclus ; formule « Free » disponible.
-
« Free » — 5 $ d’utilisation de la plateforme chaque mois.
-
« Starter » — le montant de l’abonnement est converti en crédits d’utilisation inclus.
-
Frais des Actors — vérifiez séparément les événements, l’utilisation et les coûts de plateforme inclus pour l’Actor sélectionné.
3. ScrapingBee : le meilleur choix pour obtenir du HTML via une API
Avantages — ScrapingBee
-
Les requêtes HTML simples peuvent coûter un crédit chacune.
-
Les options de rendu, de proxy et d’extraction sont accessibles par l’intermédiaire d’une seule API.
Inconvénients — ScrapingBee
-
Les paramètres modifient le coût en crédits de chaque requête.
-
La planification, le stockage et la validation en aval restent à votre charge.
ScrapingBee est mon choix pour un développeur qui souhaite déléguer la récupération des pages sans acheter une plateforme visuelle complète de traitement des données. Vous envoyez une URL et une configuration, puis exploitez la réponse dans votre propre application. Cette approche convient à une chaîne de traitement existante dans laquelle vous savez déjà comment les résultats doivent être analysés, stockés et vérifiés.
J’ai essayé son « HTML Playground » sur une page du site de test Books to Scrape. Avec « Auto mode » désactivé et le rendu JavaScript désactivé, la requête a renvoyé un code HTTP 200 et l’interface a indiqué qu’un crédit avait été débité. Cette vérification de configuration était utile ; une simple page de démonstration en dit peu sur les sites plus complexes à extraire.
Ce que j’ai constaté — ScrapingBee
Vérifiez les paramètres avant de lancer la requête, car ils déterminent le nombre de crédits consommés. Le « HTML Playground » s’est ouvert avec « Auto mode » activé. Après l’avoir désactivé, le rendu JavaScript restait coché séparément ; sa désactivation m’a permis d’obtenir la configuration souhaitée, facturée un seul crédit. Le paramètre par défaut de l’API pour le rendu JavaScript coûte cinq crédits, contre un seul pour une requête simple sans rendu.
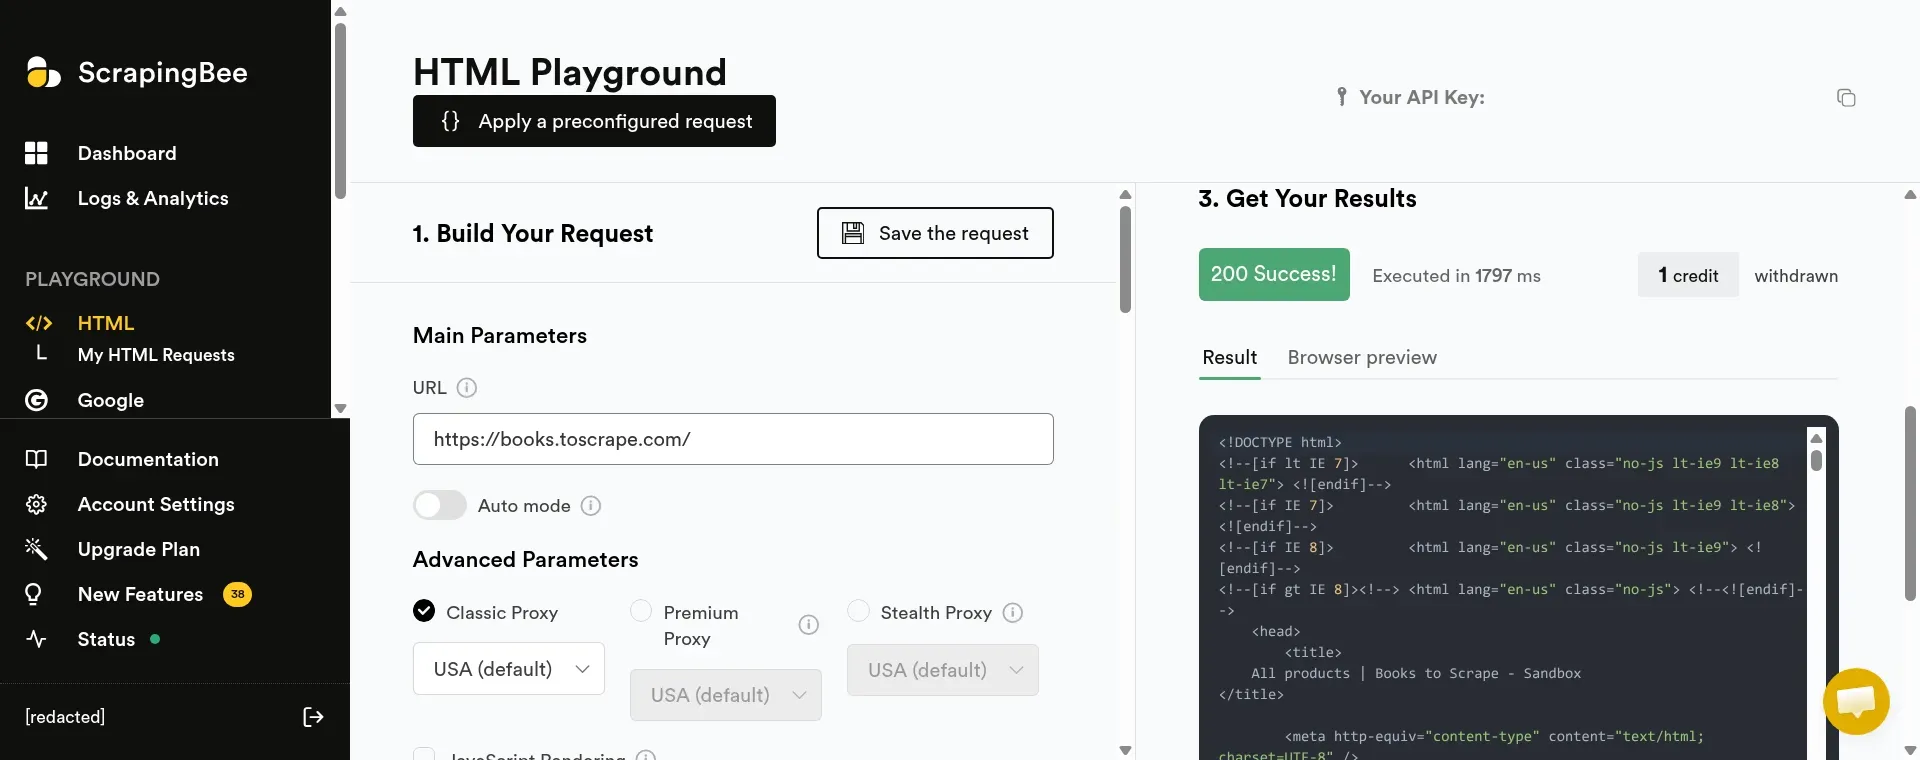
Dans le « HTML Playground » de ScrapingBee, la requête portant sur une page simple a renvoyé un résultat et indiqué le débit d’un crédit.
J’apprécie ce contrôle lorsque vos pages ne nécessitent pas de navigateur, car vous pouvez éviter de payer pour un rendu superflu. Le problème est que vous devrez tout de même transformer la page récupérée en enregistrements fiables. J’éviterais cet outil si vous souhaitez obtenir une feuille de calcul de suivi prête à l’emploi sans créer de processus autour de l’API.
Tarifs de ScrapingBee
À partir de 19 $/mois, facturés mensuellement, pour la formule « Hobby » ; un essai de 1 000 crédits est disponible.
-
« Hobby » — 19 $/mois pour 75 000 crédits et 25 requêtes simultanées.
-
« Freelance » — 49 $/mois pour 250 000 crédits et 50 requêtes simultanées.
-
Paramètres des requêtes — le HTML standard coûte un crédit ; le rendu JavaScript en coûte cinq ; les options premium coûtent davantage.
4. Firecrawl : le meilleur choix pour le contenu destiné aux applications d’AI
Avantages — Firecrawl
-
Renvoie du contenu au format Markdown ou HTML, ainsi que des données structurées.
-
Un « Playground » public vous permet d’essayer une page et d’en examiner un aperçu.
Inconvénients — Firecrawl
-
L’extraction JSON structurée ajoute des crédits au coût de base de la page.
-
Un aperçu qui s’affiche correctement ne remplace pas la vérification du résultat complet.
Firecrawl est mon choix lorsque l’étape suivante nécessite un contenu de page lisible plutôt que du HTML brut. Markdown convient aux systèmes de recherche documentaire et aux processus fondés sur l’AI ; le JSON structuré convient lorsqu’un processus en aval attend des champs nommés. J’apprécie que ces choix soient réunis au même endroit, mais je déterminerais le format nécessaire avant d’en estimer le coût.
J’ai soumis la page du site de test Books to Scrape dans le « Playground » public de Firecrawl et obtenu un aperçu Markdown qui s’est affiché correctement. Il a conservé le lien « Home » et le titre « All products ». Le résultat complet nécessitait un compte ; ma vérification s’est donc arrêtée à cet aperçu, sans exportation vérifiée de tous les produits.
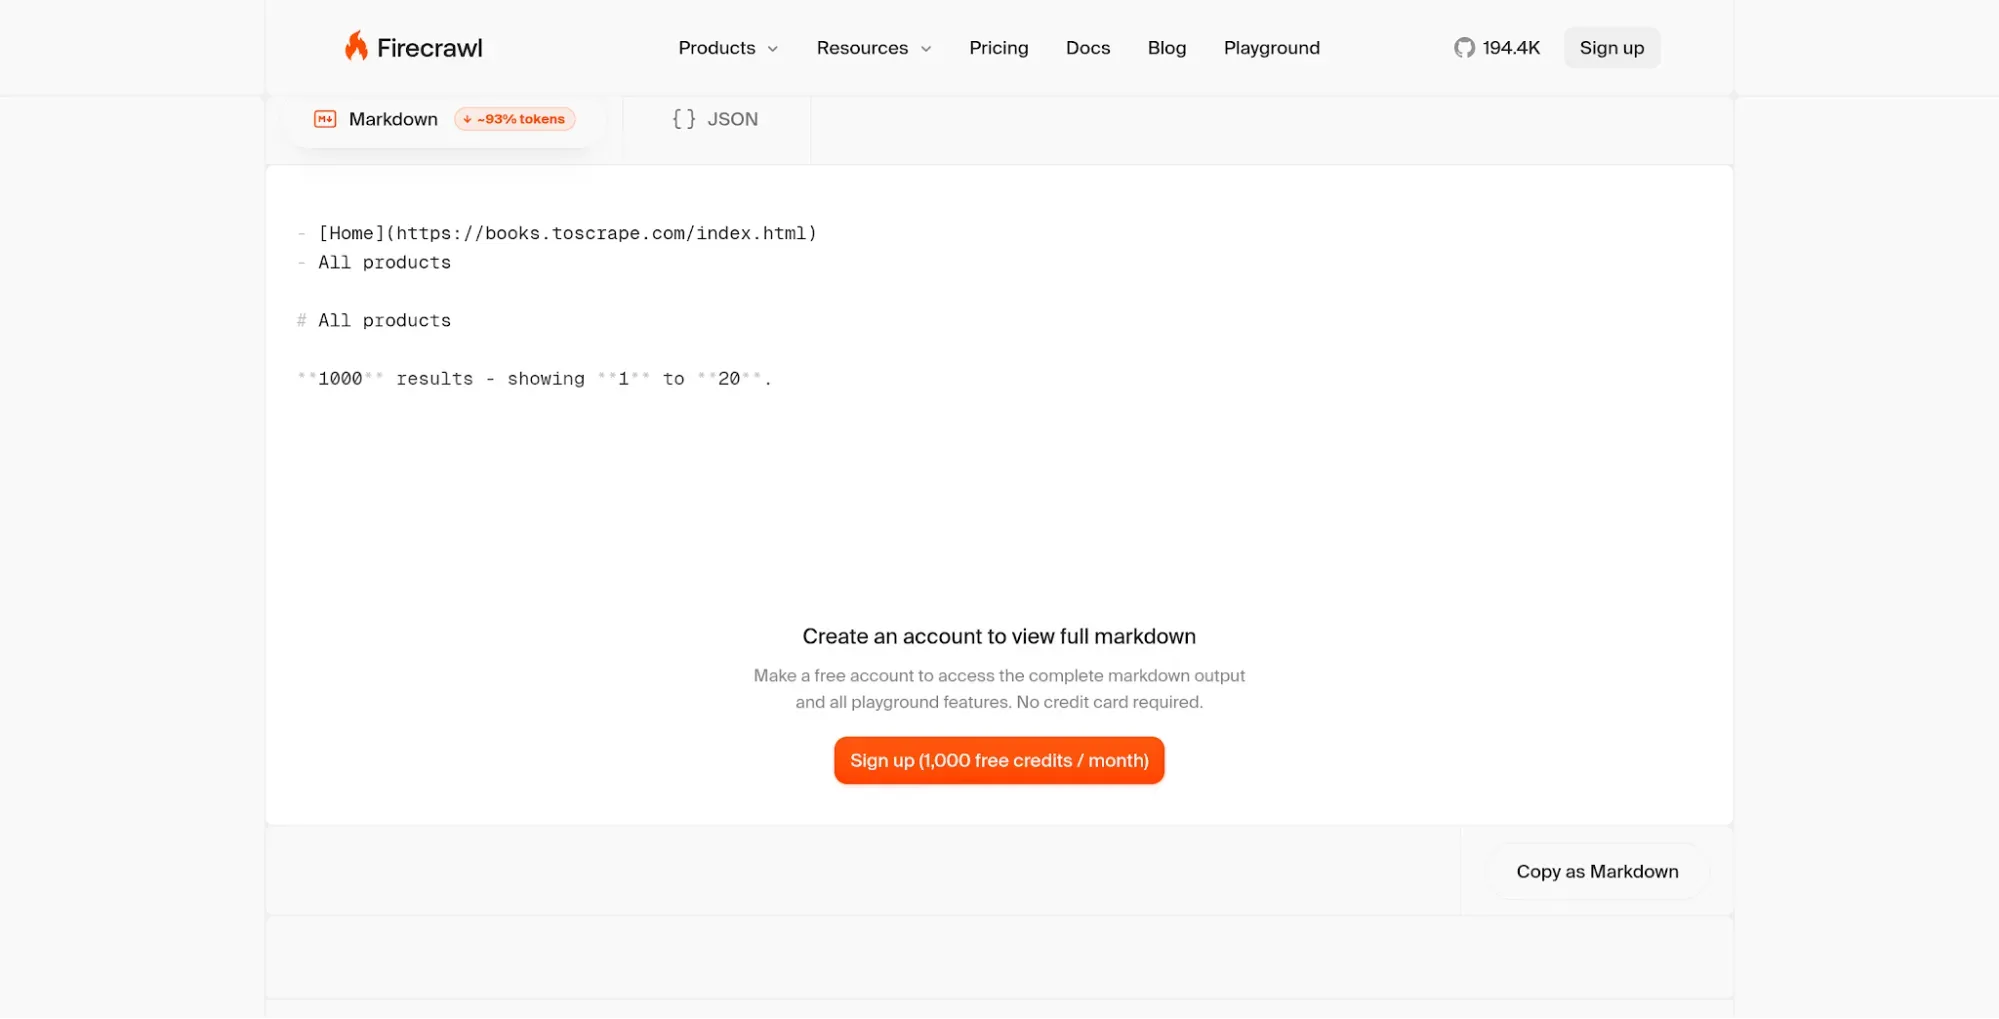
Dans le « Playground » public de Firecrawl, l’aperçu Markdown conserve la navigation et un titre de page ; le résultat complet nécessite un compte.
Ce petit détail est important : du contenu Markdown lisible ne constitue pas automatiquement un tableau propre et structuré contenant les données de chaque produit. Si vous importez un catalogue dans une base de données, vous aurez tout de même besoin d’un schéma et de contrôles des valeurs manquantes. Si vous fournissez le contexte d’une page à une application d’AI, une représentation textuelle plus large peut correspondre exactement à vos besoins.
Le principal écueil est que le format choisi peut multiplier la consommation de crédits. Une extraction de base coûte un crédit par page ; l’ajout de l’extraction JSON porte ce coût à cinq crédits. Dans une publication de septembre 2026 sur r/automation, u/Rankspartanben a salué l’assistance de Firecrawl, tout en qualifiant l’outil de “quite expensive”. J’y verrais une invitation à calculer le prix correspondant à votre propre format et à votre propre volume, plutôt qu’une raison de rejeter l’outil.
J’éviterais Firecrawl si vous avez seulement besoin d’une extraction ponctuelle au format CSV depuis une interface visuelle. Ses fonctionnalités de conversion et son API sont plus pertinentes lorsque vous créez une chaîne de traitement de contenu reproductible.
Tarifs de Firecrawl
À partir de 19 $/mois, facturés mensuellement, pour la formule « Hobby » ; formule « Free » disponible.
-
« Free » — 1 000 crédits renouvelés chaque mois.
-
« Hobby » — 19 $/mois pour 5 000 crédits mensuels ; les crédits supplémentaires coûtent 5 $ par tranche de 1 000.
-
« Standard » — 99 $/mois pour 100 000 crédits mensuels.
5. Octoparse : le meilleur choix pour les processus visuels qui passent de l’application de bureau au cloud
Avantages — Octoparse
-
L’extraction locale gratuite vous permet de commencer sans abonnement.
-
La formule « Standard » ajoute l’extraction dans le cloud, la planification et une API d’exportation des données.
Inconvénients — Octoparse
-
La planification classique dans le cloud nécessite une formule payante ; les quotas de la version bêta d’« AI Assistant » sont différents.
-
Les services facultatifs de proxy et de configuration peuvent s’ajouter au prix de la formule.
Octoparse mérite votre attention si vous souhaitez concevoir des processus d’extraction dans une interface visuelle tout en conservant la possibilité de les exécuter dans le cloud. Vous pouvez commencer à partir de modèles, de son « AI Assistant » ou de l’application de bureau. Les formules classiques payantes permettent d’exécuter et de planifier dans le cloud les tâches qui ne doivent pas dépendre de votre propre ordinateur.
J’apprécie la distinction entre le travail local et le travail dans le cloud, car elle vous donne un critère d’achat concret. Si vous exportez un catalogue une fois par mois depuis votre ordinateur, l’option locale gratuite peut suffire. Si ce même catalogue doit être actualisé chaque matin, la planification de la formule « Standard » est la fonctionnalité que vous achetez réellement.
Pour l’utilisation classique de l’application de bureau, la formule « Free » comprend dix tâches, un appareil et 50 000 lignes exportées par mois, dans la limite de 10 000 lignes par exportation. La formule « Standard » porte le quota à 100 tâches et comprend jusqu’à trois processus simultanés dans le cloud. Ces chiffres correspondent à des éléments différents : une tâche correspond à un processus enregistré, tandis que les lignes exportées correspondent aux données qu’il produit.
Ce que j’ai constaté — Octoparse
La console gratuite offrait davantage que l’utilisation de l’application de bureau à laquelle je m’attendais. Son « AI Assistant » m’a permis de choisir la version bêta de « Cloud Agent », qui écrit et exécute un outil de scraping personnalisé. J’ai ouvert cette option sans acheter de formule. Je la distinguerais de la comparaison portant sur la planification classique : je n’ai pas vérifié l’existence d’un quota récurrent pour cette version bêta.
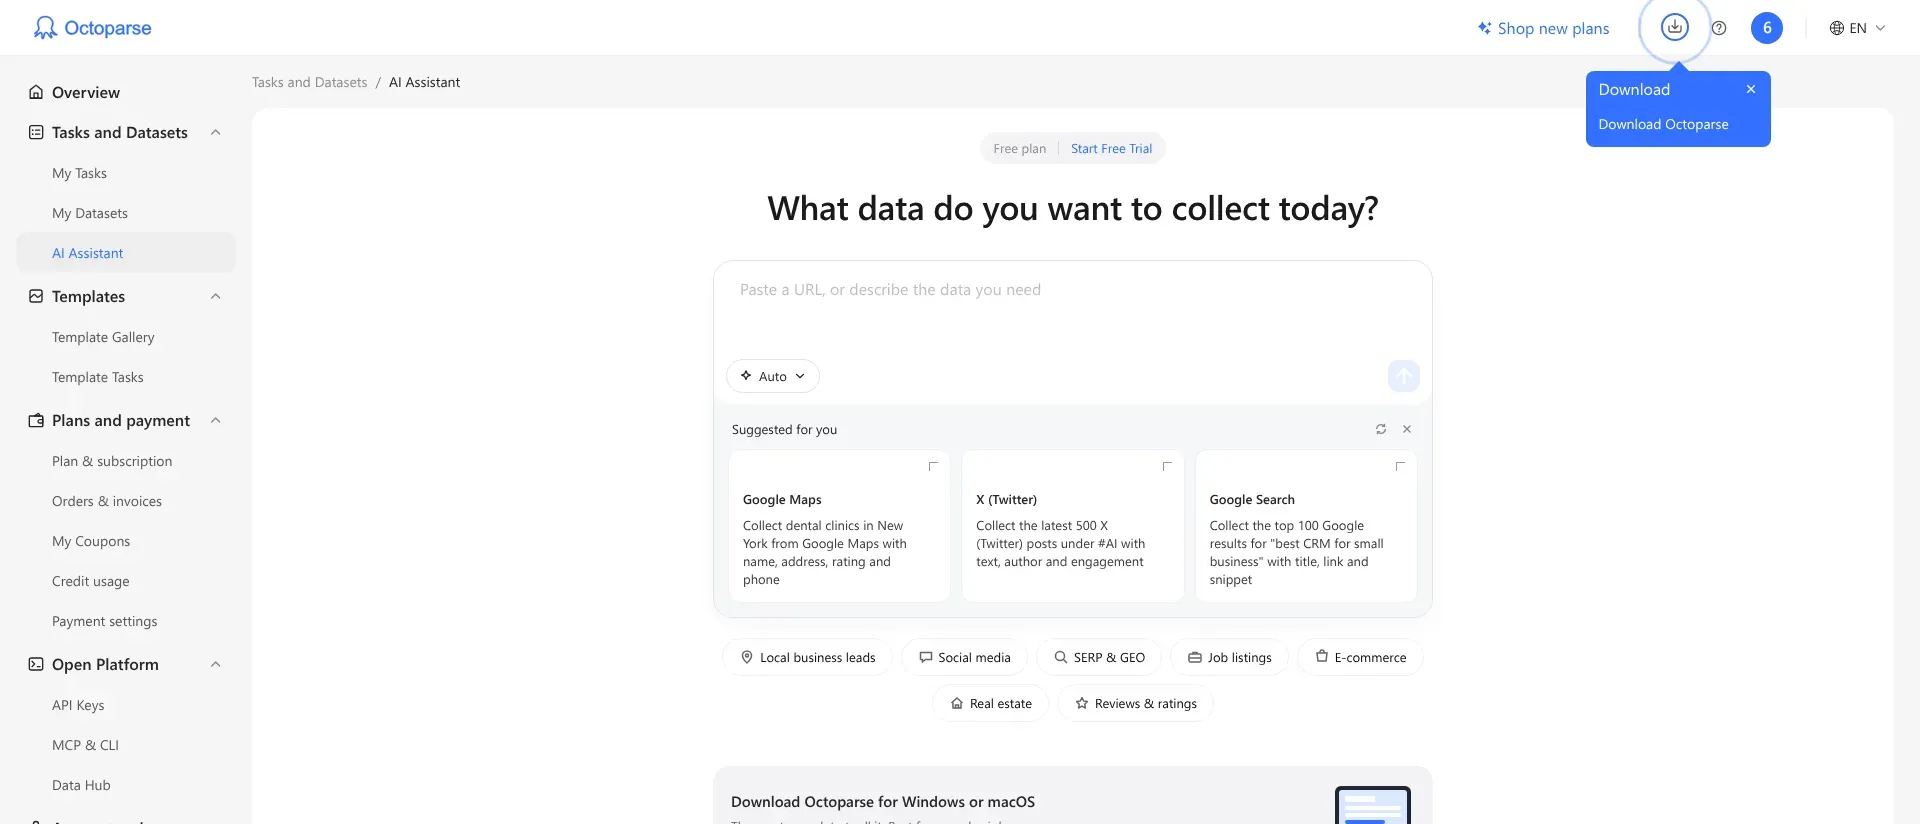
Dans la formule « Free » d’Octoparse, « AI Assistant » propose un point de départ fondé sur une instruction saisie par l’utilisateur, en complément de l’application de bureau.
Le problème est que l’approche « sans code » ne supprime pas la maintenance du processus. Lorsqu’une page change, une personne doit toujours vérifier les champs sélectionnés et les données renvoyées. J’éviterais cet outil si vous préférez une intégration conçue autour d’une API et disposez déjà d’un parseur ; ScrapingBee répond plus directement à ce besoin.
Tarifs d’Octoparse
À partir de 69 $/mois, facturés annuellement, pour la formule « Standard » ; formule « Free » disponible.
-
« Free » — extraction locale, dix tâches et 50 000 lignes exportées par mois.
-
« Standard » — 69 $/mois, facturés annuellement, avec extraction dans le cloud et planification.
-
« Professional » — 249 $/mois, facturés annuellement, avec 20 processus simultanés dans le cloud.
6. Scrapy : le meilleur choix pour les explorations web personnalisées en Python
Avantages — Scrapy
-
Aucun coût de licence logicielle et un contrôle complet des sélecteurs et du traitement.
-
Les exportations de flux intégrées prennent notamment en charge les formats CSV et JSON.
Inconvénients — Scrapy
-
Le code, l’environnement d’exécution et la maintenance restent à votre charge.
-
Le rendu dans un navigateur nécessite une intégration distincte lorsque la page l’exige.
Scrapy est mon choix lorsque la logique d’extraction doit rester dans le code source de votre projet. Vous écrivez un robot d’exploration pour sélectionner les champs et suivre les liens nécessaires, puis utilisez des chaînes de traitement et des flux d’exportation pour traiter et exporter les résultats. Vous pouvez ainsi traiter explicitement les cas particuliers au lieu de contraindre chaque site à entrer dans un modèle visuel.
J’ai testé Scrapy 2.19.0 sur un catalogue local synthétique contenant trois produits. Le robot d’exploration a exporté les données aux formats CSV et JSON, et le produit dont le stock était nul a conservé cette valeur. J’ai également fixé l’ordre des champs CSV comme suit : title, price, stock. Cette vérification n’a nécessité ni compte ni service payant.
Ce que j’ai constaté — Scrapy
Même lorsque l’exportation aboutit, les décisions relatives aux types de données vous reviennent. Mes sélecteurs ont renvoyé les prix et les stocks sous forme de chaînes de caractères : 12.50 et 0 ont été conservés, mais le robot d’exploration ne les a pas transformés lui-même en champs numériques. J’apprécie ce fonctionnement explicite dans une chaîne de traitement maintenue dans la durée. Vous devrez définir des règles de conversion et de validation avant d’effectuer des calculs en aval.
Le problème concerne tout ce qui entoure le robot d’exploration. Vous êtes responsable de l’hébergement, de la planification, d’un mécanisme de relance des requêtes adapté au site et des alertes lorsque le résultat change. Scrapy ne sait pas non plus effectuer seul le rendu des pages qui dépendent de JavaScript ; vous pourriez avoir besoin d’une autre source de données ou d’une intégration avec un navigateur.
J’éviterais Scrapy si personne dans votre équipe ne souhaite assurer la maintenance d’un projet en Python. Un logiciel gratuit peut constituer une bonne affaire, mais il ne fait pas disparaître le temps de développement et de maintenance.
Tarifs de Scrapy
Licence logicielle gratuite ; l’exécution et la maintenance représentent des coûts distincts.
-
Cadre logiciel — à code source ouvert, sans frais logiciels par page.
-
Exploitation — prévoyez un budget pour votre propre hébergement, votre suivi et votre travail de développement.
Coût d’une même charge de travail
L’option la moins chère dépend du format de sortie et de la personne ou de l’équipe qui assure l’exécution. Les chiffres suivants sont calculés à partir des formules vérifiées ; ils ne proviennent pas de tests à grande échelle. Les prix sont indiqués en USD hors taxes, sans sites premium, serveurs proxy payants ni services de configuration facultatifs. Le temps de développement et de maintenance n’est pas inclus.
Scénario 1 : contrôle quotidien et planifié d’un catalogue au moyen d’un outil visuel
Supposons qu’une page publique standard compatible avec l’outil contienne 20 lignes et soit récupérée une fois par jour pendant 30 jours chaque mois. Cela représente 600 lignes et 30 exécutions mensuelles. La comparaison exige une exécution autonome et planifiée dans le cloud, ainsi qu’un tableau configuré. Les exécutions locales de la formule classique « Free » d’Octoparse ne répondent pas à cette exigence ; les quotas récurrents de la version bêta d’« AI Assistant » n’ayant pas été vérifiés, cette dernière n’est pas tarifée comme un service planifié équivalent.
| Outil | Formule adaptée | Abonnement annuel | Suppléments obligatoires pour ce scénario | Limite à surveiller |
|---|---|---|---|---|
| Browse AI | « Personal », facturation annuelle | 228 $ payés d’avance | Aucun selon les hypothèses indiquées | 60 crédits/mois ; 720/an sur 12 000 |
| Octoparse | « Standard », facturation annuelle | 828 $ payés d’avance | Aucun selon les hypothèses indiquées | Une tâche sur 100 ; trois processus dans le cloud |
Je commencerais par Browse AI pour ce petit tableau régulièrement actualisé si le robot peut être configuré correctement pour cette page. Le surcoût d’Octoparse se justifie davantage si vous avez également besoin de son processus complet, de l’application de bureau au cloud. Avant de choisir l’un ou l’autre, vérifiez que tous les champs nécessaires se trouvent sur cette page unique : la visite des pages de détail modifie la charge de travail.
Scénario 2 : 10 000 requêtes de pages HTML simples par mois
Supposons 10 000 requêtes réussies renvoyant des pages en HTML brut, sans rendu JavaScript, serveurs proxy premium ni extraction de champs assistée par l’AI. Votre application assure la planification, l’analyse et le stockage. Les totaux reposent sur douze paiements mensuels, afin de ne pas intégrer une remise liée au prépaiement annuel dans la comparaison.
| Outil | Formule adaptée | Coût sur 12 mois | Suppléments obligatoires inclus | Limite à surveiller |
|---|---|---|---|---|
| ScrapingBee | « Hobby », facturation mensuelle | 228 $ | Aucun ; 10 000 crédits sont couverts par la formule | 75 000 crédits/mois ; désactivez le rendu JavaScript |
| Firecrawl | « Hobby » avec paiement à l’utilisation | 528 $ | 25 $/mois pour 5 000 crédits supplémentaires | Activez le paiement à l’utilisation (« PAYG ») avec un quota mensuel suffisant |
ScrapingBee utilise ici 10 000 crédits mensuels. Firecrawl atteint 44 $ par mois une fois les crédits supplémentaires inclus ; il est inutile de passer à la formule « Standard » pour cette charge de travail.
Selon ces hypothèses, je choisirais ScrapingBee. Si le résultat attendu devient des données JSON extraites par l’AI, refaites le calcul : Firecrawl utilise cinq crédits par page, et l’extraction assistée par l’AI de ScrapingBee ajoute cinq crédits à la requête sous-jacente. La comparaison des requêtes HTML à faible coût ne répond alors plus à votre question.
Apify et Scrapy nécessitent une estimation différente. Les règles tarifaires et le temps d’exécution d’un Actor Apify déterminent son coût total ; la licence de Scrapy est gratuite, mais son hébergement et la main-d’œuvre ne le sont pas. Je n’attribuerais pas un total annuel inventé à l’un ou à l’autre sans exécution représentative ni plan d’exploitation.
Vérifiez d’abord les outils que vous utilisez déjà
Une fonction de feuille de calcul ou une exportation proposée par la source peut suffire à une petite tâche avant que vous n’ajoutiez un nouvel abonnement. La fonction IMPORTHTML de Google Sheets peut importer un tableau ou une liste HTML selon son index. Le connecteur « From Web » de Power Query dans Excel vous permet de sélectionner les tableaux détectés et de transformer les résultats.
J’essaierais ces solutions pour un tableau occasionnel et simple. Dès que le processus exige des interactions avec un navigateur, plusieurs modèles de pages ou une exécution fiable sans surveillance, un outil de scraping dédié devient plus utile. Vérifiez également si la source propose une API adaptée ou un fichier téléchargeable : un flux de données prêt à l’emploi peut vous éviter d’avoir à reconstruire sa structure à partir d’une page.
Pour les processus de prospection propres à LinkedIn, consultez le guide de l’automatisation de Sales Navigator de Linked Helper. Il s’agit d’un usage distinct de l’extraction de données à partir de pages web publiques diverses.
À lire également :
- Les meilleurs outils de scraping LinkedIn en 2026 (gratuits et payants)
- Exporter des leads LinkedIn vers CSV
Quel outil de web scraping devriez-vous choisir ?
| Votre scénario | Mon choix | Le critère décisif |
|---|---|---|
| Tableau régulièrement actualisé | Browse AI | Choisissez en fonction du résultat dont vous avez besoin et du travail que votre équipe est prête à prendre en charge. Je commencerais par Browse AI pour un tableau régulièrement actualisé. |
| Configuration visuelle dans une application de bureau et exécution payante dans le cloud | Octoparse | Envisagez Octoparse si ces caractéristiques correspondent à votre manière de travailler. |
| Un Actor maintenu réalise déjà la tâche précise | Apify | Vérifiez son exemple de jeu de données et ses règles tarifaires avant de considérer que le prix de départ de la plateforme correspond à votre budget total. |
| La récupération du HTML est le maillon manquant d’une chaîne de traitement gérée par des développeurs | ScrapingBee | Je choisirais ScrapingBee lorsque la récupération du HTML est le maillon manquant. |
| La conversion du contenu est essentielle | Firecrawl | Je choisirais Firecrawl lorsque la conversion du contenu est essentielle. |
| La logique d’extraction, les types de données et la maintenance doivent rester en Python | Scrapy | Scrapy est l’option que je choisirais lorsque ces éléments doivent rester sous le contrôle de mon équipe. |
Quelle que soit l’option retenue, comparez un petit échantillon de résultats avec la source avant de programmer une extraction à plus grande échelle. Le test le plus utile consiste à vérifier que les champs nécessaires sont correctement récupérés, y compris les valeurs manquantes et la dernière page des résultats.
Autres outils que j’ai envisagés
Playwright mérite votre attention lorsque vous devez programmer des interactions personnalisées avec un navigateur. Il s’agit d’un cadre d’automatisation de navigateur ; vous devrez donc tout de même développer les fonctions d’extraction et de stockage nécessaires.